舆情监测与智能研判 Agent
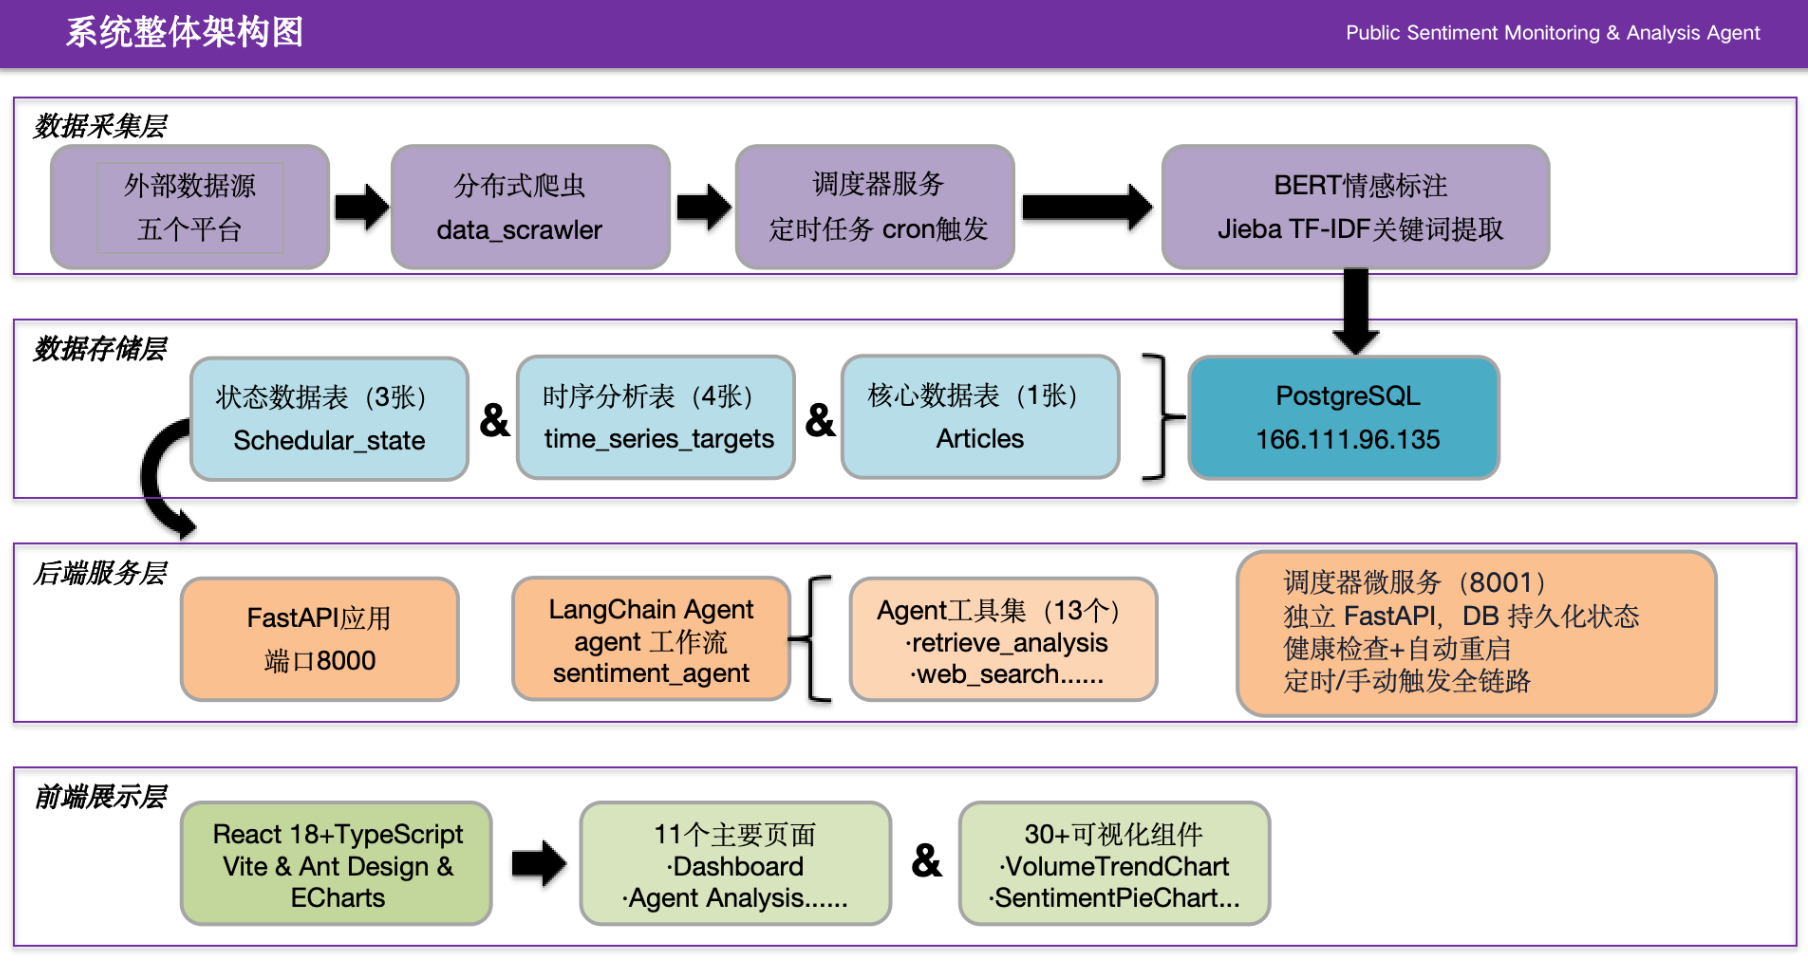
图 1|「清舆智析」整体架构:采集 → 存储 → 服务 → 展示
2026-10-14 更新: 项目已完整交付,本文重写为结项版,补充完整交付清单、系统架构与各模块的技术实现。
项目是什么
「清舆智析」是一套面向中文社交媒体的舆情监测与智能研判平台,用四周时间从零搭建完成。
- 目标:打通「自动采集 → 情感分析 → 时序分析 → 预警研判」全流程,让整个监测流程无人值守地持续运转
- 面向场景:高校 / 机构舆情管理,数据源覆盖视频社区、兴趣社区、问答社区、校园树洞与校友社区
- 两个入口:一套 Web Dashboard(11 个功能页面)负责看板、词云、趋势、平台对比、预警清单;一个对话式舆情助手,用自然语言提问,Agent 自己决定调哪些工具、拿什么证据、怎么给结论
最终交付了什么
| 交付项 | 完成情况 |
|---|---|
| 源代码 | 单仓库管理,287 次提交,main 分支可直接运行 |
| Web Dashboard | 11 个功能页面,30 余个可视化组件(ECharts) |
| 对话式助手 | 13 个 LangChain 工具 + 2 个 Skill |
| 后端服务 | FastAPI,40+ REST 端点 + WebSocket 实时推送 |
| 数据采集 | 视频社区、兴趣社区、问答社区、校友社区、校园树洞,五个平台 + 统一调度器 |
| 情感分析 | DistilBERT 多语言情感模型 + jieba TF-IDF 关键词 |
| 时序分析 | 滑动窗口聚合 + 趋势预测 + 结果持久化 |
| 预警研判 | 红 / 橙 / 黄三级规则引擎 + 预警流水线 + LLM 语义研判 |
| 数据库 | PostgreSQL 16:1 张核心表 + 4 张时序表 |
| 部署 | Docker Compose,start.sh 一键启停 |
| 项目文档 | 10 份:需求规格说明书、Sprint Backlog、数据库设计、模块设计、API 文档、系统测试报告、用户使用手册、项目总结报告、部署文档、Agent 与 Prompt 交付总结 |
系统架构
整体分五层,层与层之间解耦,每一层都可以独立开发、独立测试:
- 数据采集层:五个平台的独立爬虫 + 一个统一调度器,采集后自动触发情感标注
- 数据存储层:PostgreSQL 16,1 张核心内容表 + 4 张时序分析表
- 后端服务层:FastAPI 提供 REST 与 WebSocket,内部挂 LangChain Agent(13 个工具)和定时调度微服务
- 前端展示层:React 18 + TypeScript,11 个页面
- 运维层:Docker Compose 容器化,GitHub Actions 做 CI
五个技术模块
1. 数据采集:五个平台,一个调度器
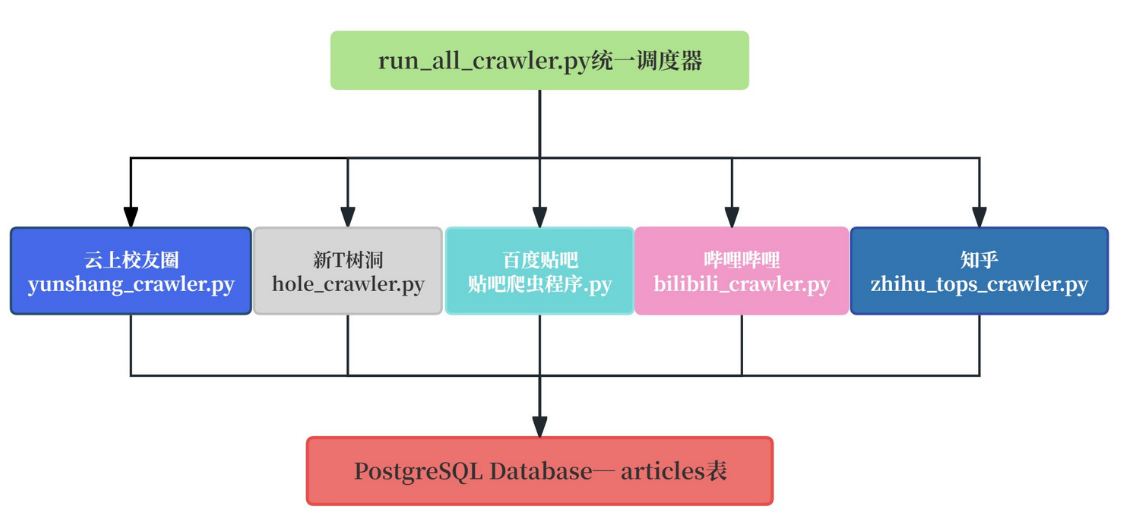
图 2|数据采集层:调度器统一编排五个平台的爬虫
- 视频社区爬虫基于
bilibili-api异步库,通过asyncpg直写数据库,支持「热门推荐」和「关键词搜索」两种模式,采集视频最近 24 小时内的评论并拼接成 content 字段 - 校友社区爬虫调用微信小程序接口,只取距爬取时刻 24 小时内的增量帖子;评论不足时以帖子正文作为 content
- 兴趣社区、问答社区、校园树洞分别通过浏览器自动化和平台接口补充社区讨论数据
调度器 run_all_crawler.py 统一管理各平台爬虫,依次运行,采集完成后自动触发情感标注脚本,形成「采集即入库、入库即分析」的流水线。所有爬虫都采用增量时间窗口,内置随机延迟、批次休眠和最大重试次数等反爬策略,保证长期运行的稳定性。
2. 情感分析:两个引擎各干各的
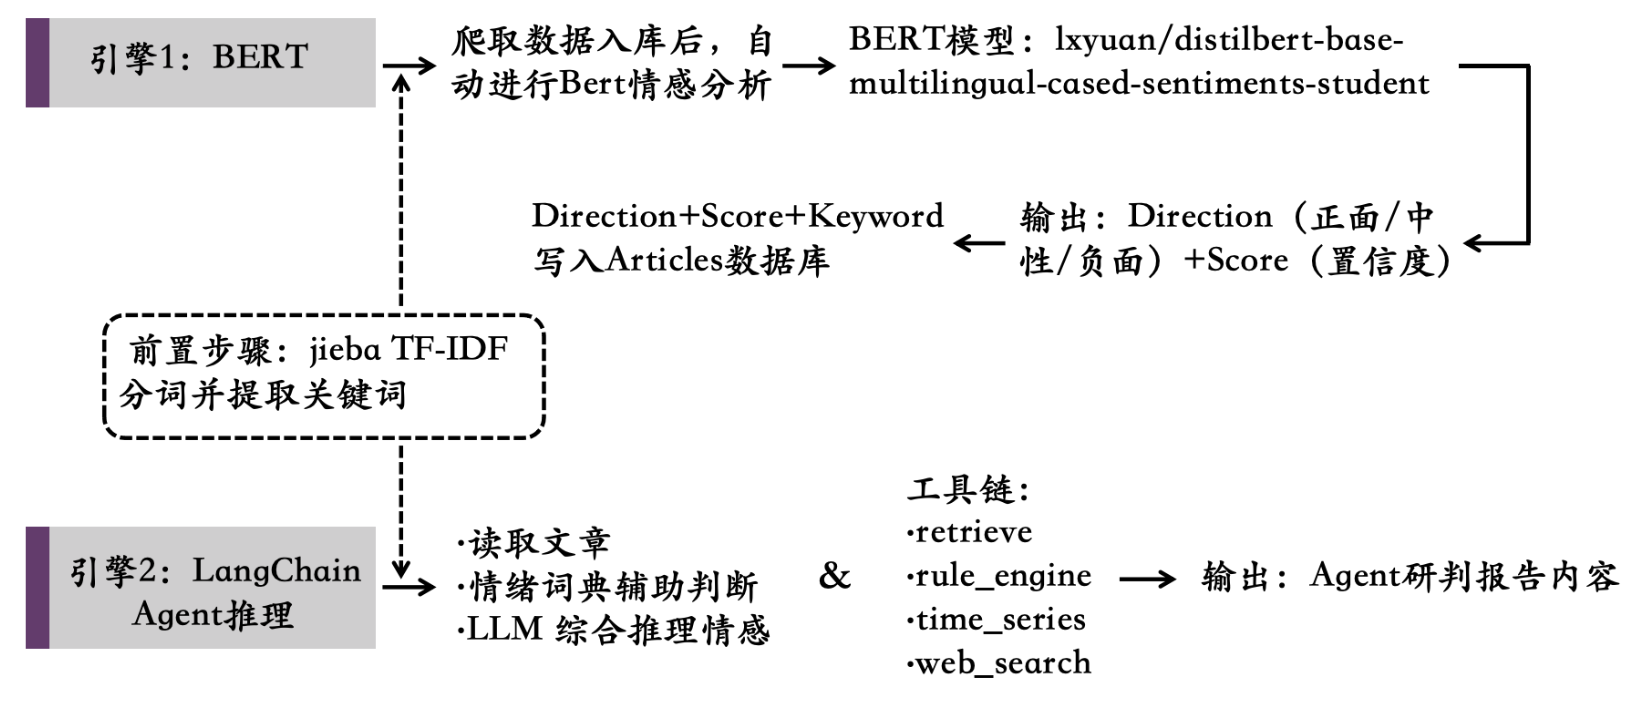
图 3|情感分析的两个引擎:自动打分的 BERT,和按需推理的 Agent
- 引擎一(自动):爬取数据入库后立即跑 DistilBERT 多语言情感模型,输出 Direction(正面 / 中性 / 负面)与 Score(置信度),直接写进库
- 引擎二(按需):jieba TF-IDF 分词并提取关键词,服务于 Agent 的检索、关键词追踪、时序分析等总结性功能
这里有个刻意的取舍:大批量的初筛交给本地模型和分词来做,LLM 只用来处理真正需要判断的部分。在舆情监测这种对实时性敏感的任务里,这一步省下的是实打实的费用和时间。
入库的「关键词—得分」向量最终收敛成 10 个字段:
id, author, title, content, time, platform,
direction(情感方向), score(置信度), keyword, parent_keyword
其中 title / content 双级关键词的设计值得一提。我们把每个平台的内容拆成两层:title 是母内容(帖子的标题、帖子主内容),content 是子内容(评论、回复)。对 title 和 content 分别提关键词,再把 content 与所属 title 拼在一起做情感打分。举个例子:帖子标题是「评价一下学校食堂好不好吃」,下面两条评论分别是「食堂非常难吃」和「好吃」。如果只对评论单独提关键词,第二条评论里根本没有「食堂」这个词,检索时就会永远漏掉它。拼上母话题之后,两条评论都能被准确召回。
3. Agent 语义研判层
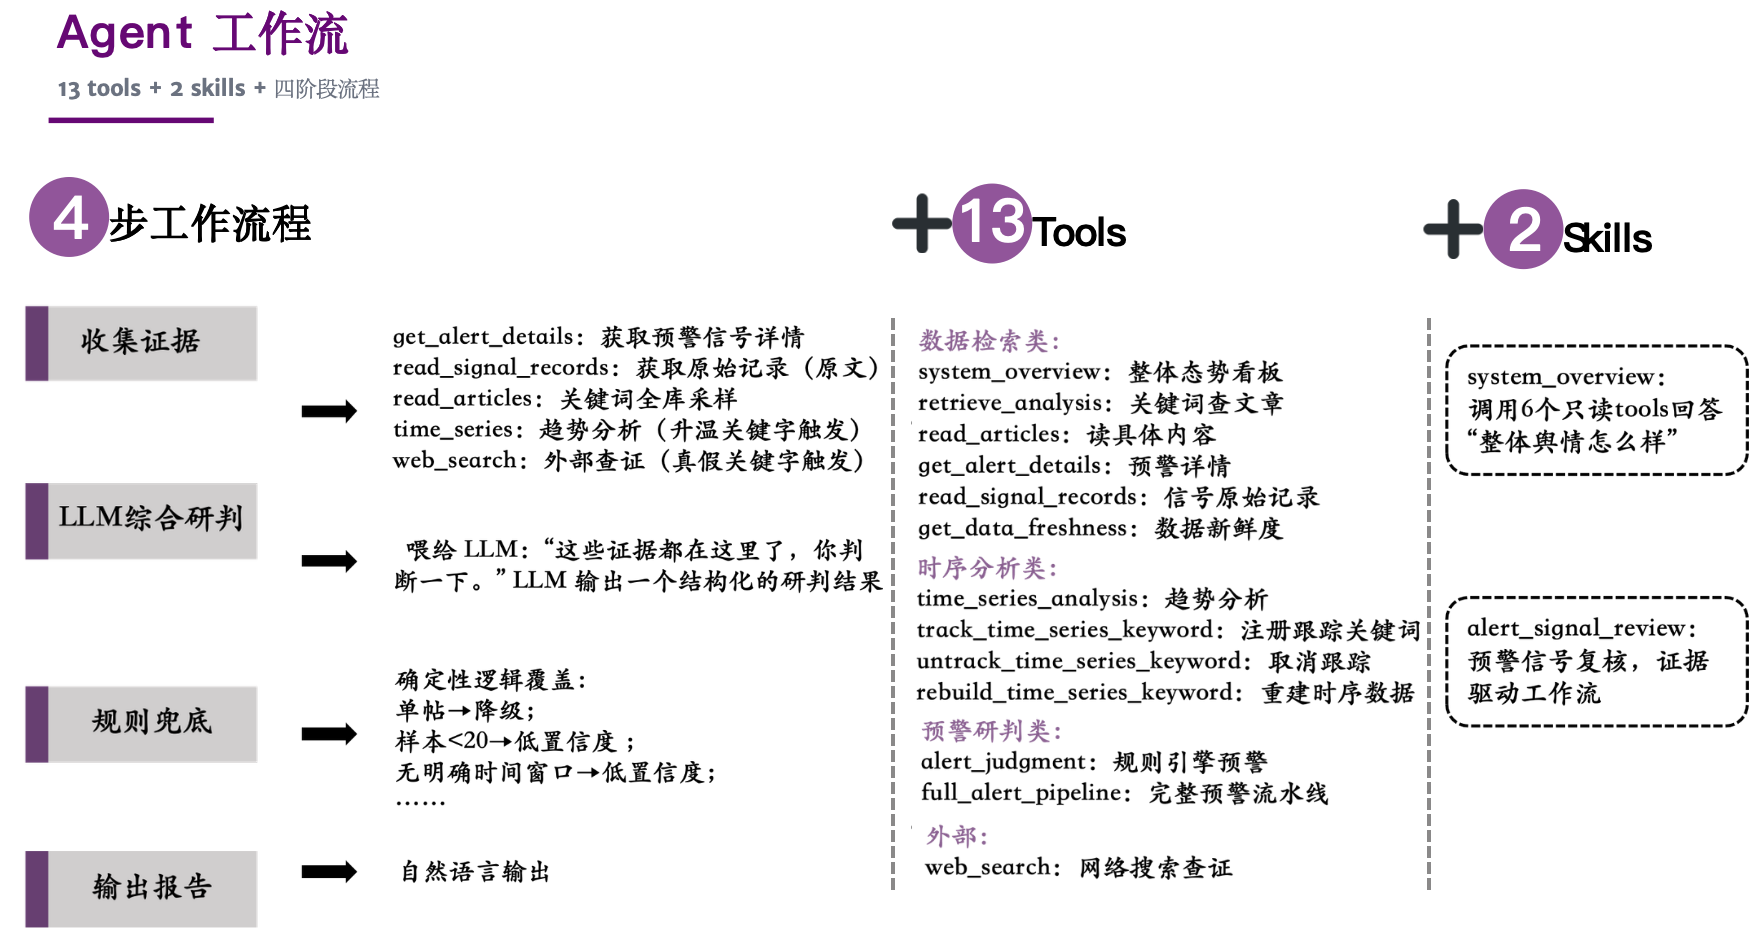
图 4|Agent 工作流:收集证据 → LLM 综合研判 → 规则兜底
研判层基于 LangChain ReAct 与 LangGraph 构建,共封装 13 个工具,覆盖系统总览、信号检索、时序分析、规则预警、预警流水线、关键词追踪与外部搜索等能力:
- 数据检索类:
system_overview(整体态势)、retrieve_analysis(关键词查文章)、read_articles(读具体内容)、get_alert_details(预警详情)、read_signal_records(信号原始记录) - 时序类:
time_series(趋势分析)、time_series_targets(跟踪目标) - 预警类:
rule_engine(规则预警判断)、stage_alert(多关键词分组预警流水线) - 外部与上下文:
web_search(外部查证)、system_context(数据新鲜度等)
几个设计上的坚持:
- 证据有优先级:本地原文 > 本地可复核统计 > 系统输出 > 外部信息 > Agent 推断。推理可以补位,但不能越过证据。
- 结构化契约:工具之间传递的是 Pydantic 定义的 schema(
AlertReviewResult、EvidenceEnvelope等),不是自由文本,避免「一段话说得挺像那么回事」的幻觉结论。 - 规则兜底:确定性逻辑覆盖一部分结论,例如只有单条帖子时自动降级,样本不足时收窄结论范围。
- 成本控制:Agent 实例按 Skill 缓存复用、按任务动态装载工具,能力完整的前提下少花冤枉钱。
4. 预警:规则引擎 + 预警流水线
预警模块由两部分组成。rule_engine.py 负责计算基线与分级评估,输出红、橙、黄三级预警,所有阈值与词典走配置中心,运营人员在前端「系统设置」里就能实时调整;stage_alert.py 把与关键词相关的所有文章按 parent_keyword 分组,逐组评估等级,最后输出全局综合研判结论。两者共享同一套核心逻辑,可以被 Agent 工具或 API 层独立调用。
我们坚持「高召回、不合并」:每个来源保留自己的观察对象、窗口、阈值、等级和证据,来源信号之间可以互相印证,但不用简单加权、投票或平均去合成一个事件结论;单个来源信号也能独立进入展示和研判。同时,来源信号、对象状态、事件等级、证据置信度这四个维度严格分离——「高优先级 + 低置信度」是完全合法的状态:疑似人身安全的事件哪怕只有一条帖子也需要立刻核验,但它不会被表述成「事件已经证实」。
5. 前端:11 个页面和一个「问 AI」
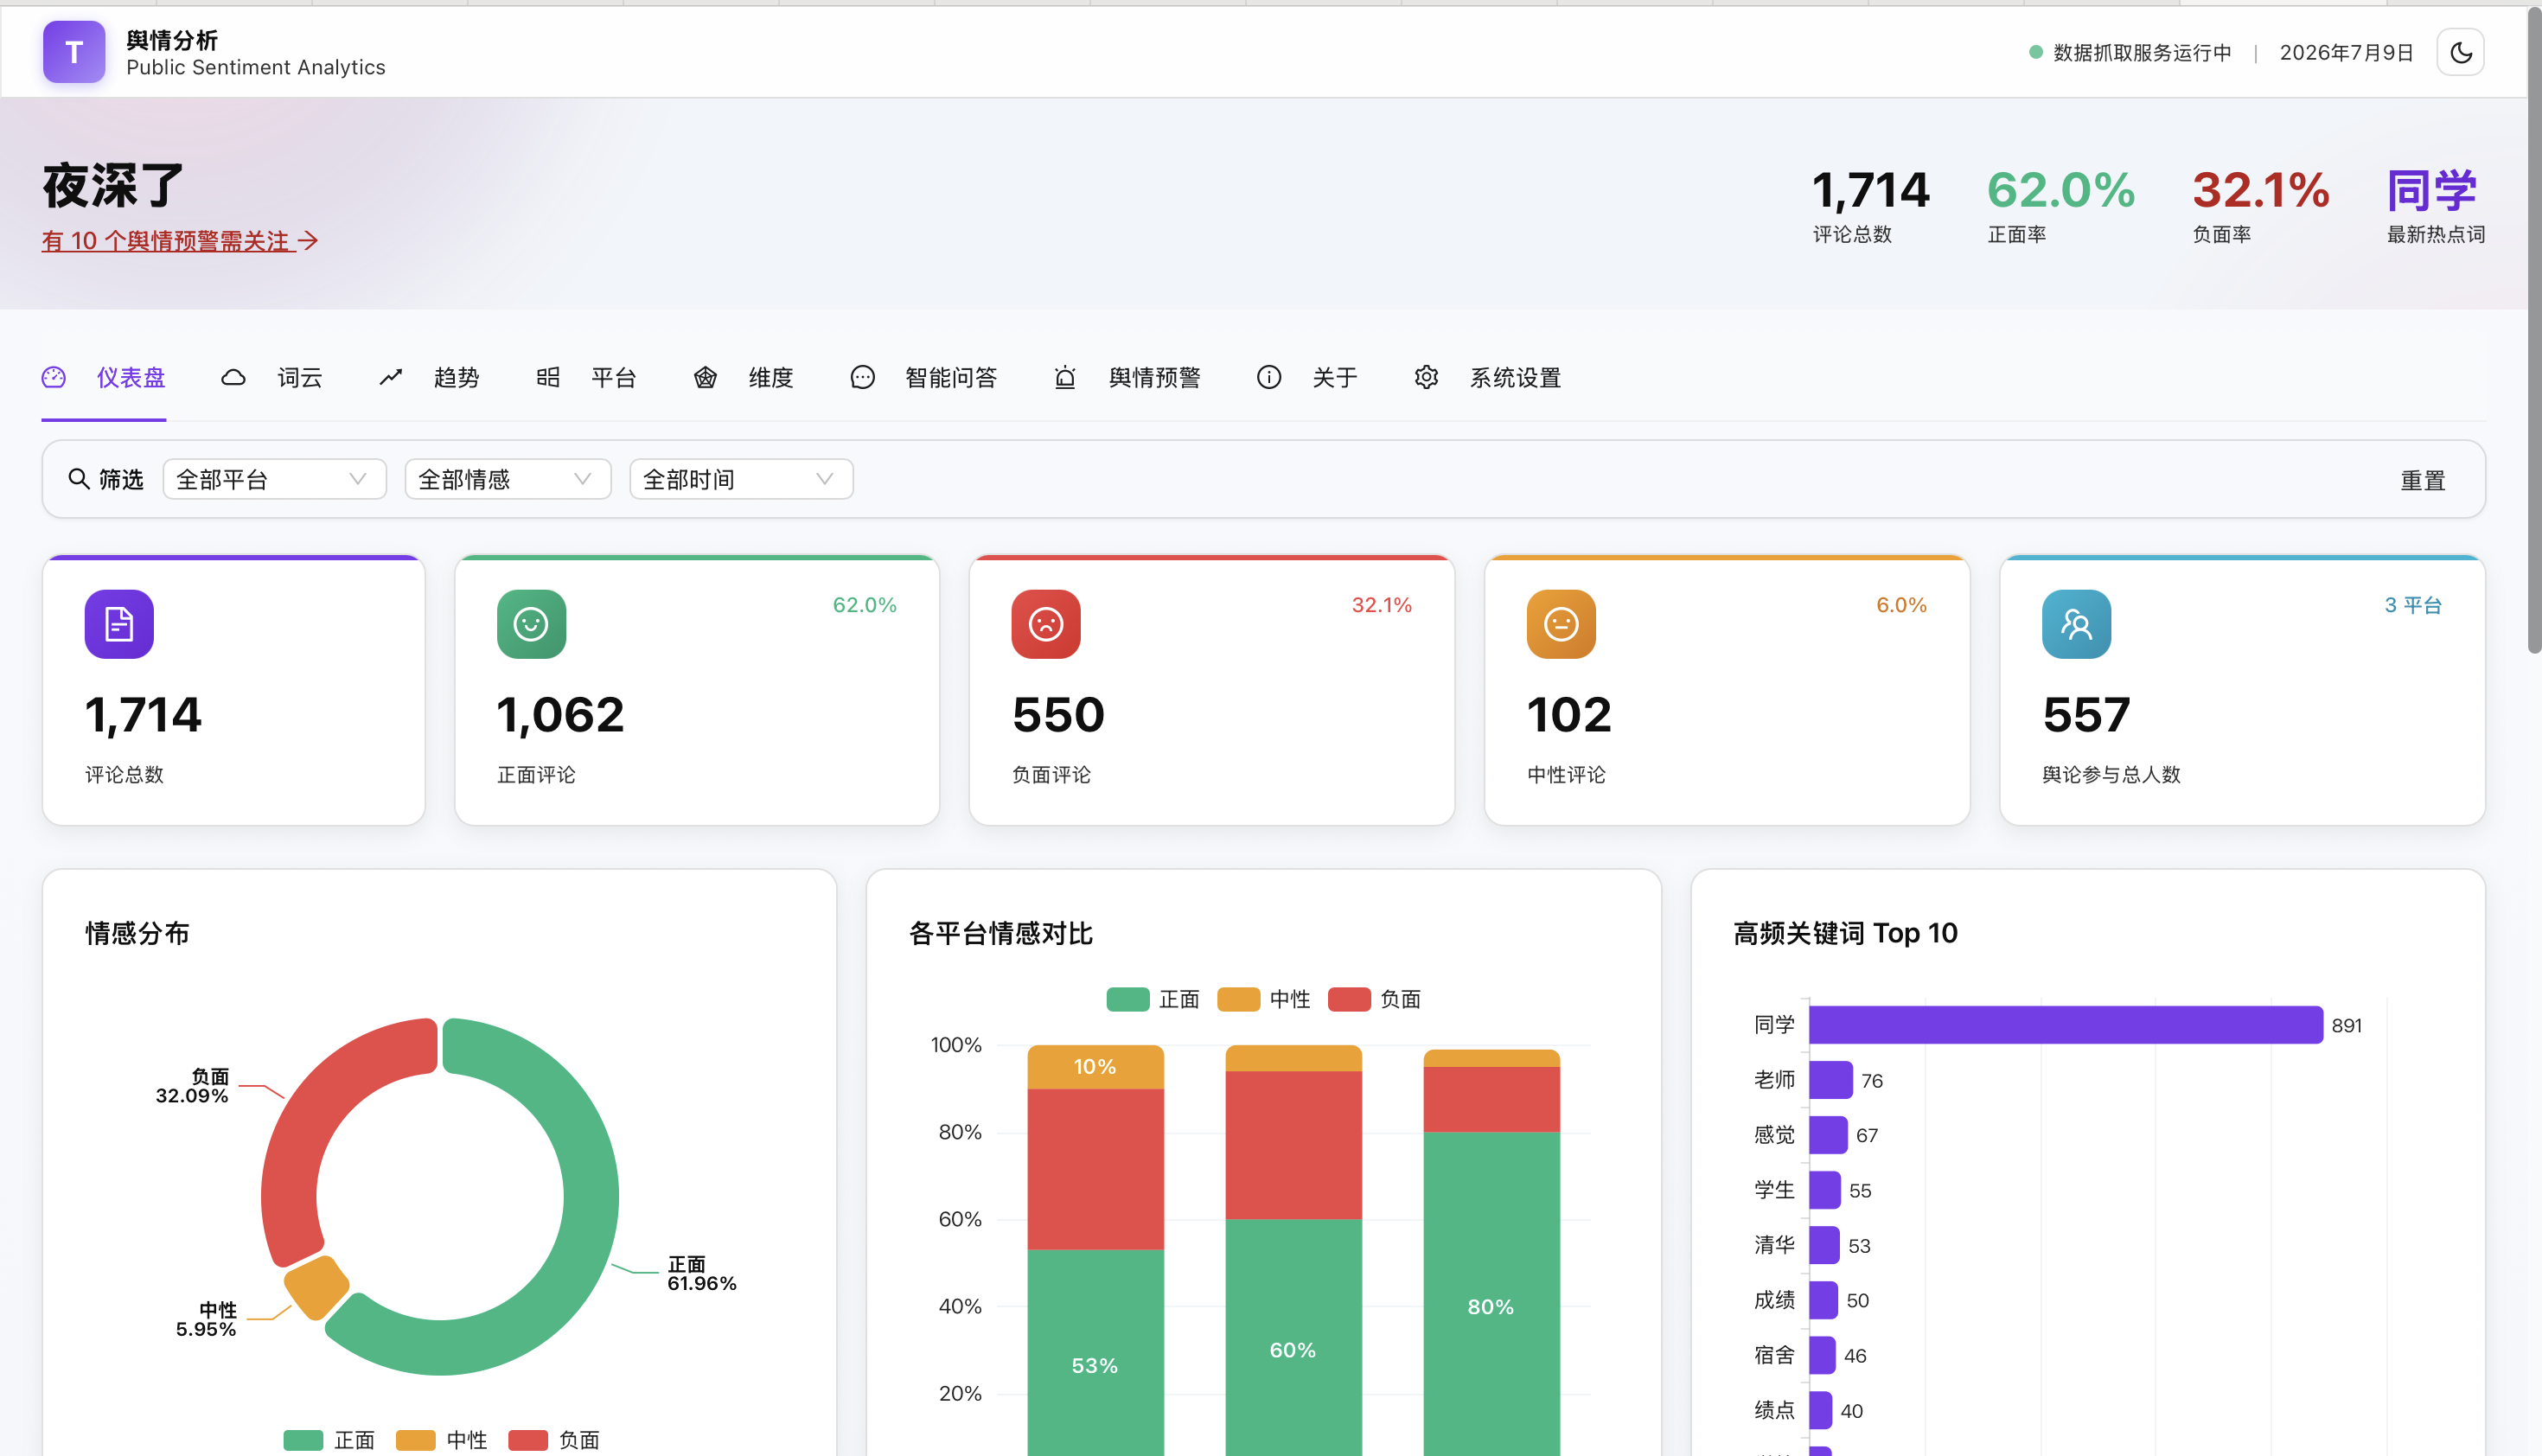
图 5|仪表盘:评论总量、正负面比例、情感分布、平台对比与高频关键词
前端基于 React 18 + TypeScript + Vite,用 Ant Design 5 与 ECharts 5,Zustand 管全局状态,axios 和 Socket.IO 对接后端。
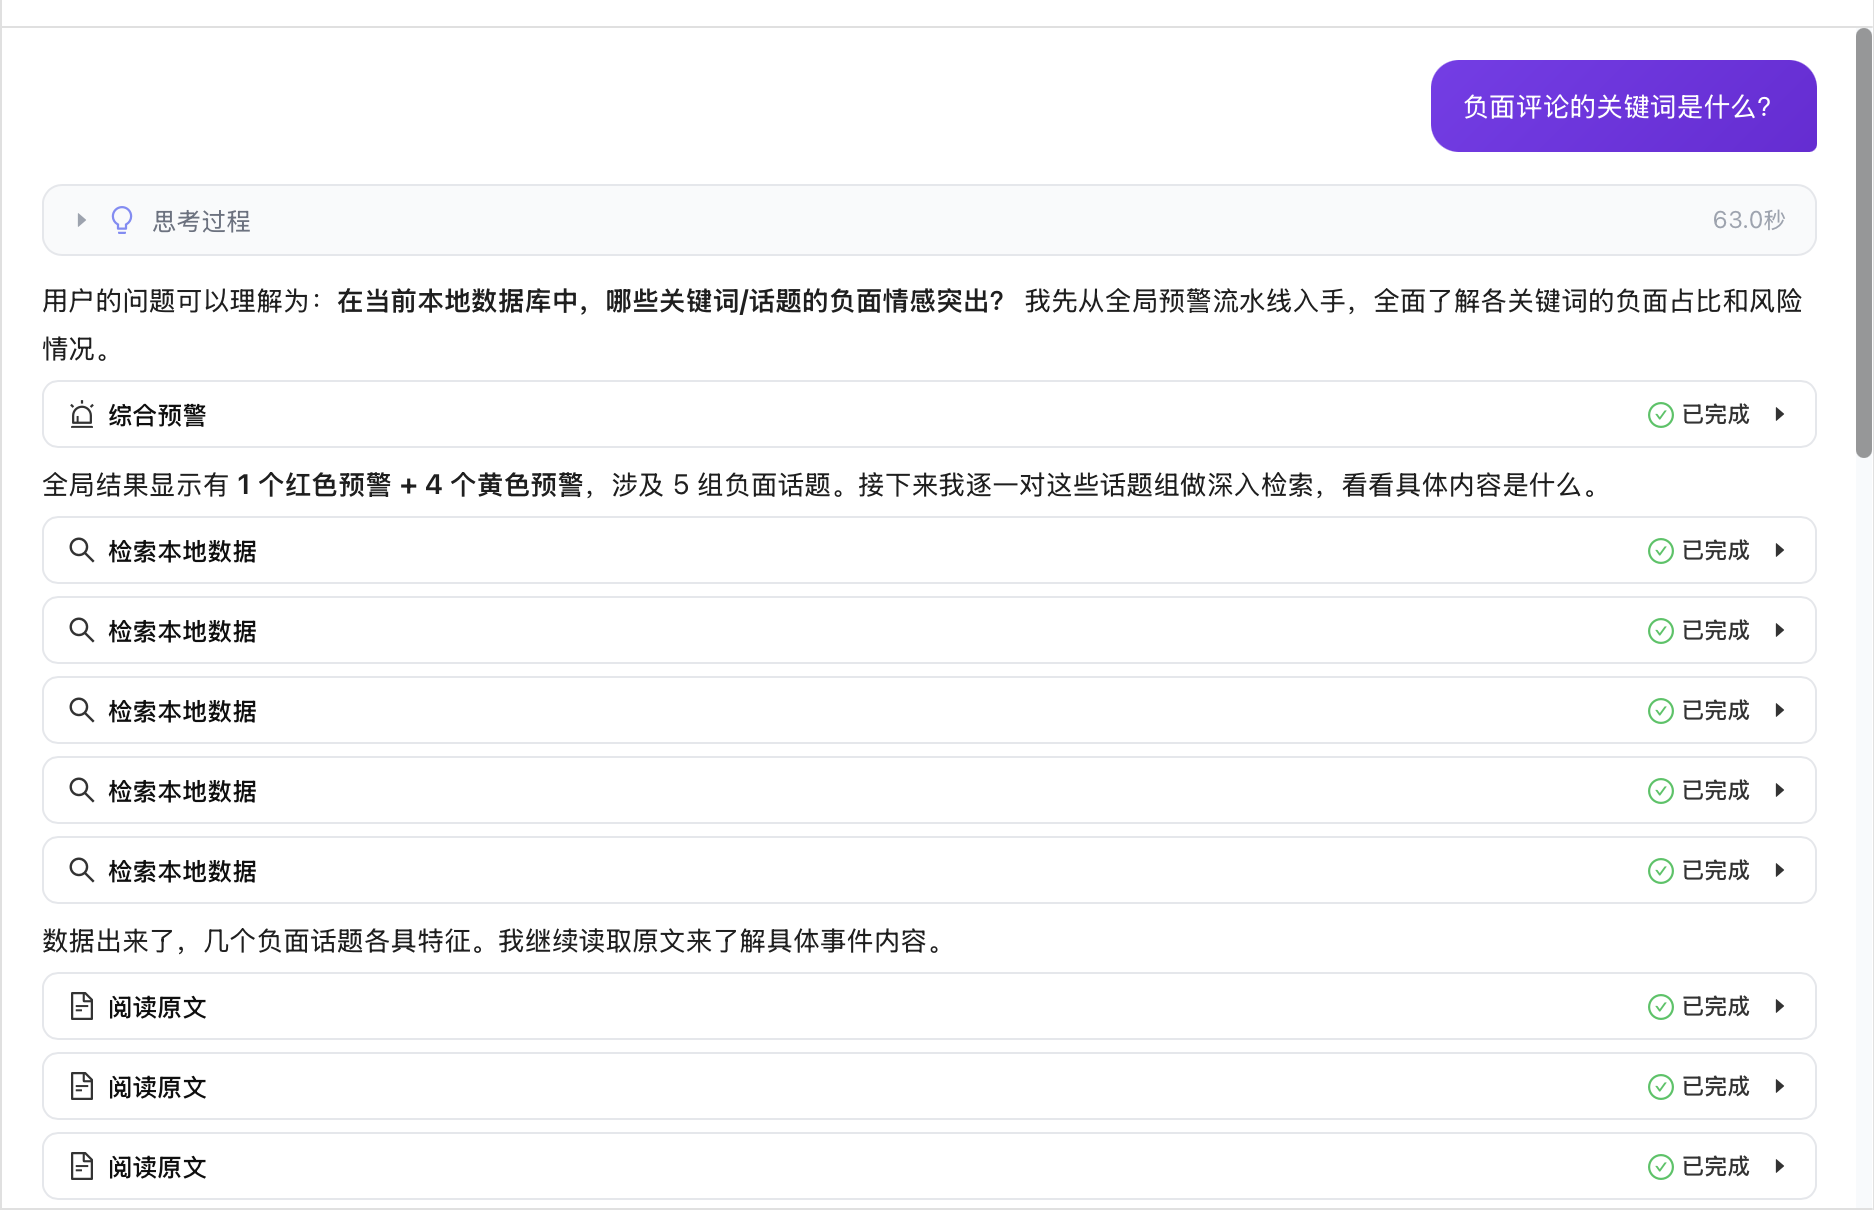
图 6|智能问答:每一次工具调用都有可视化卡片,思维链流式展开
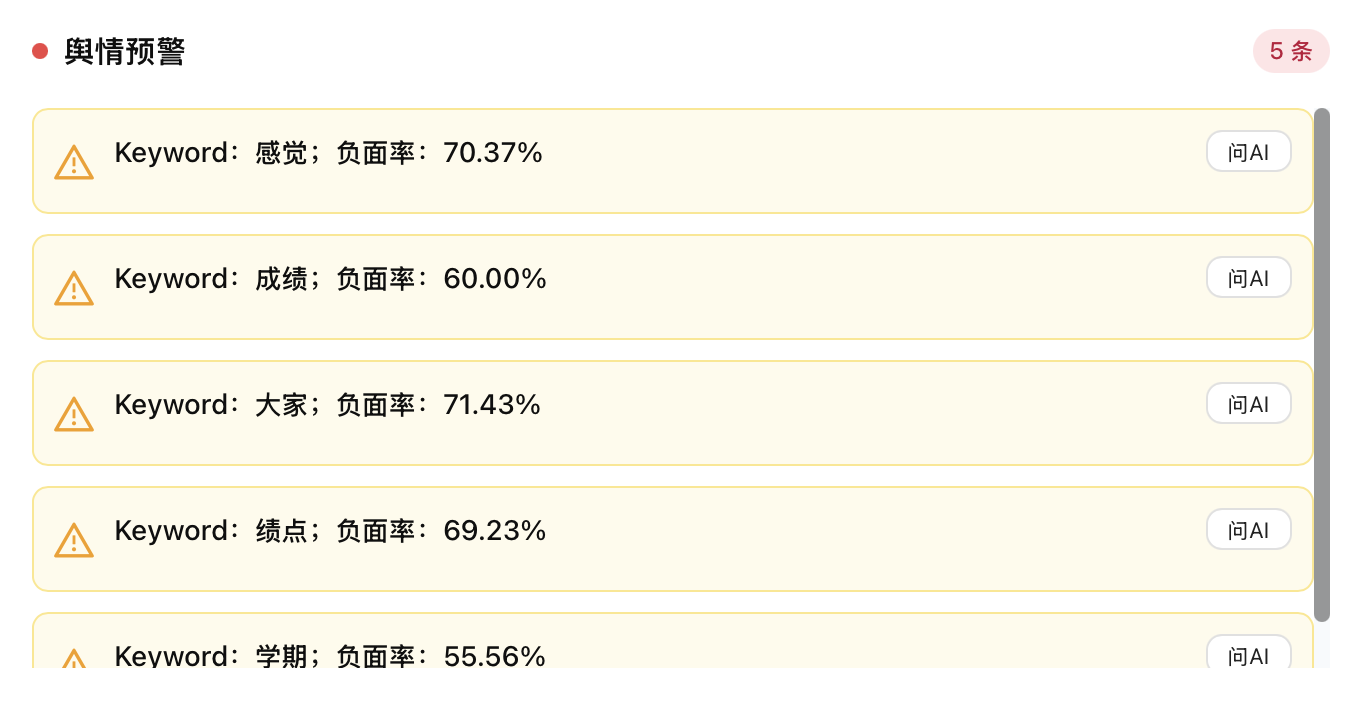
图 7|舆情预警:每条信号可一键下钻到原始证据,也可以直接「问 AI」
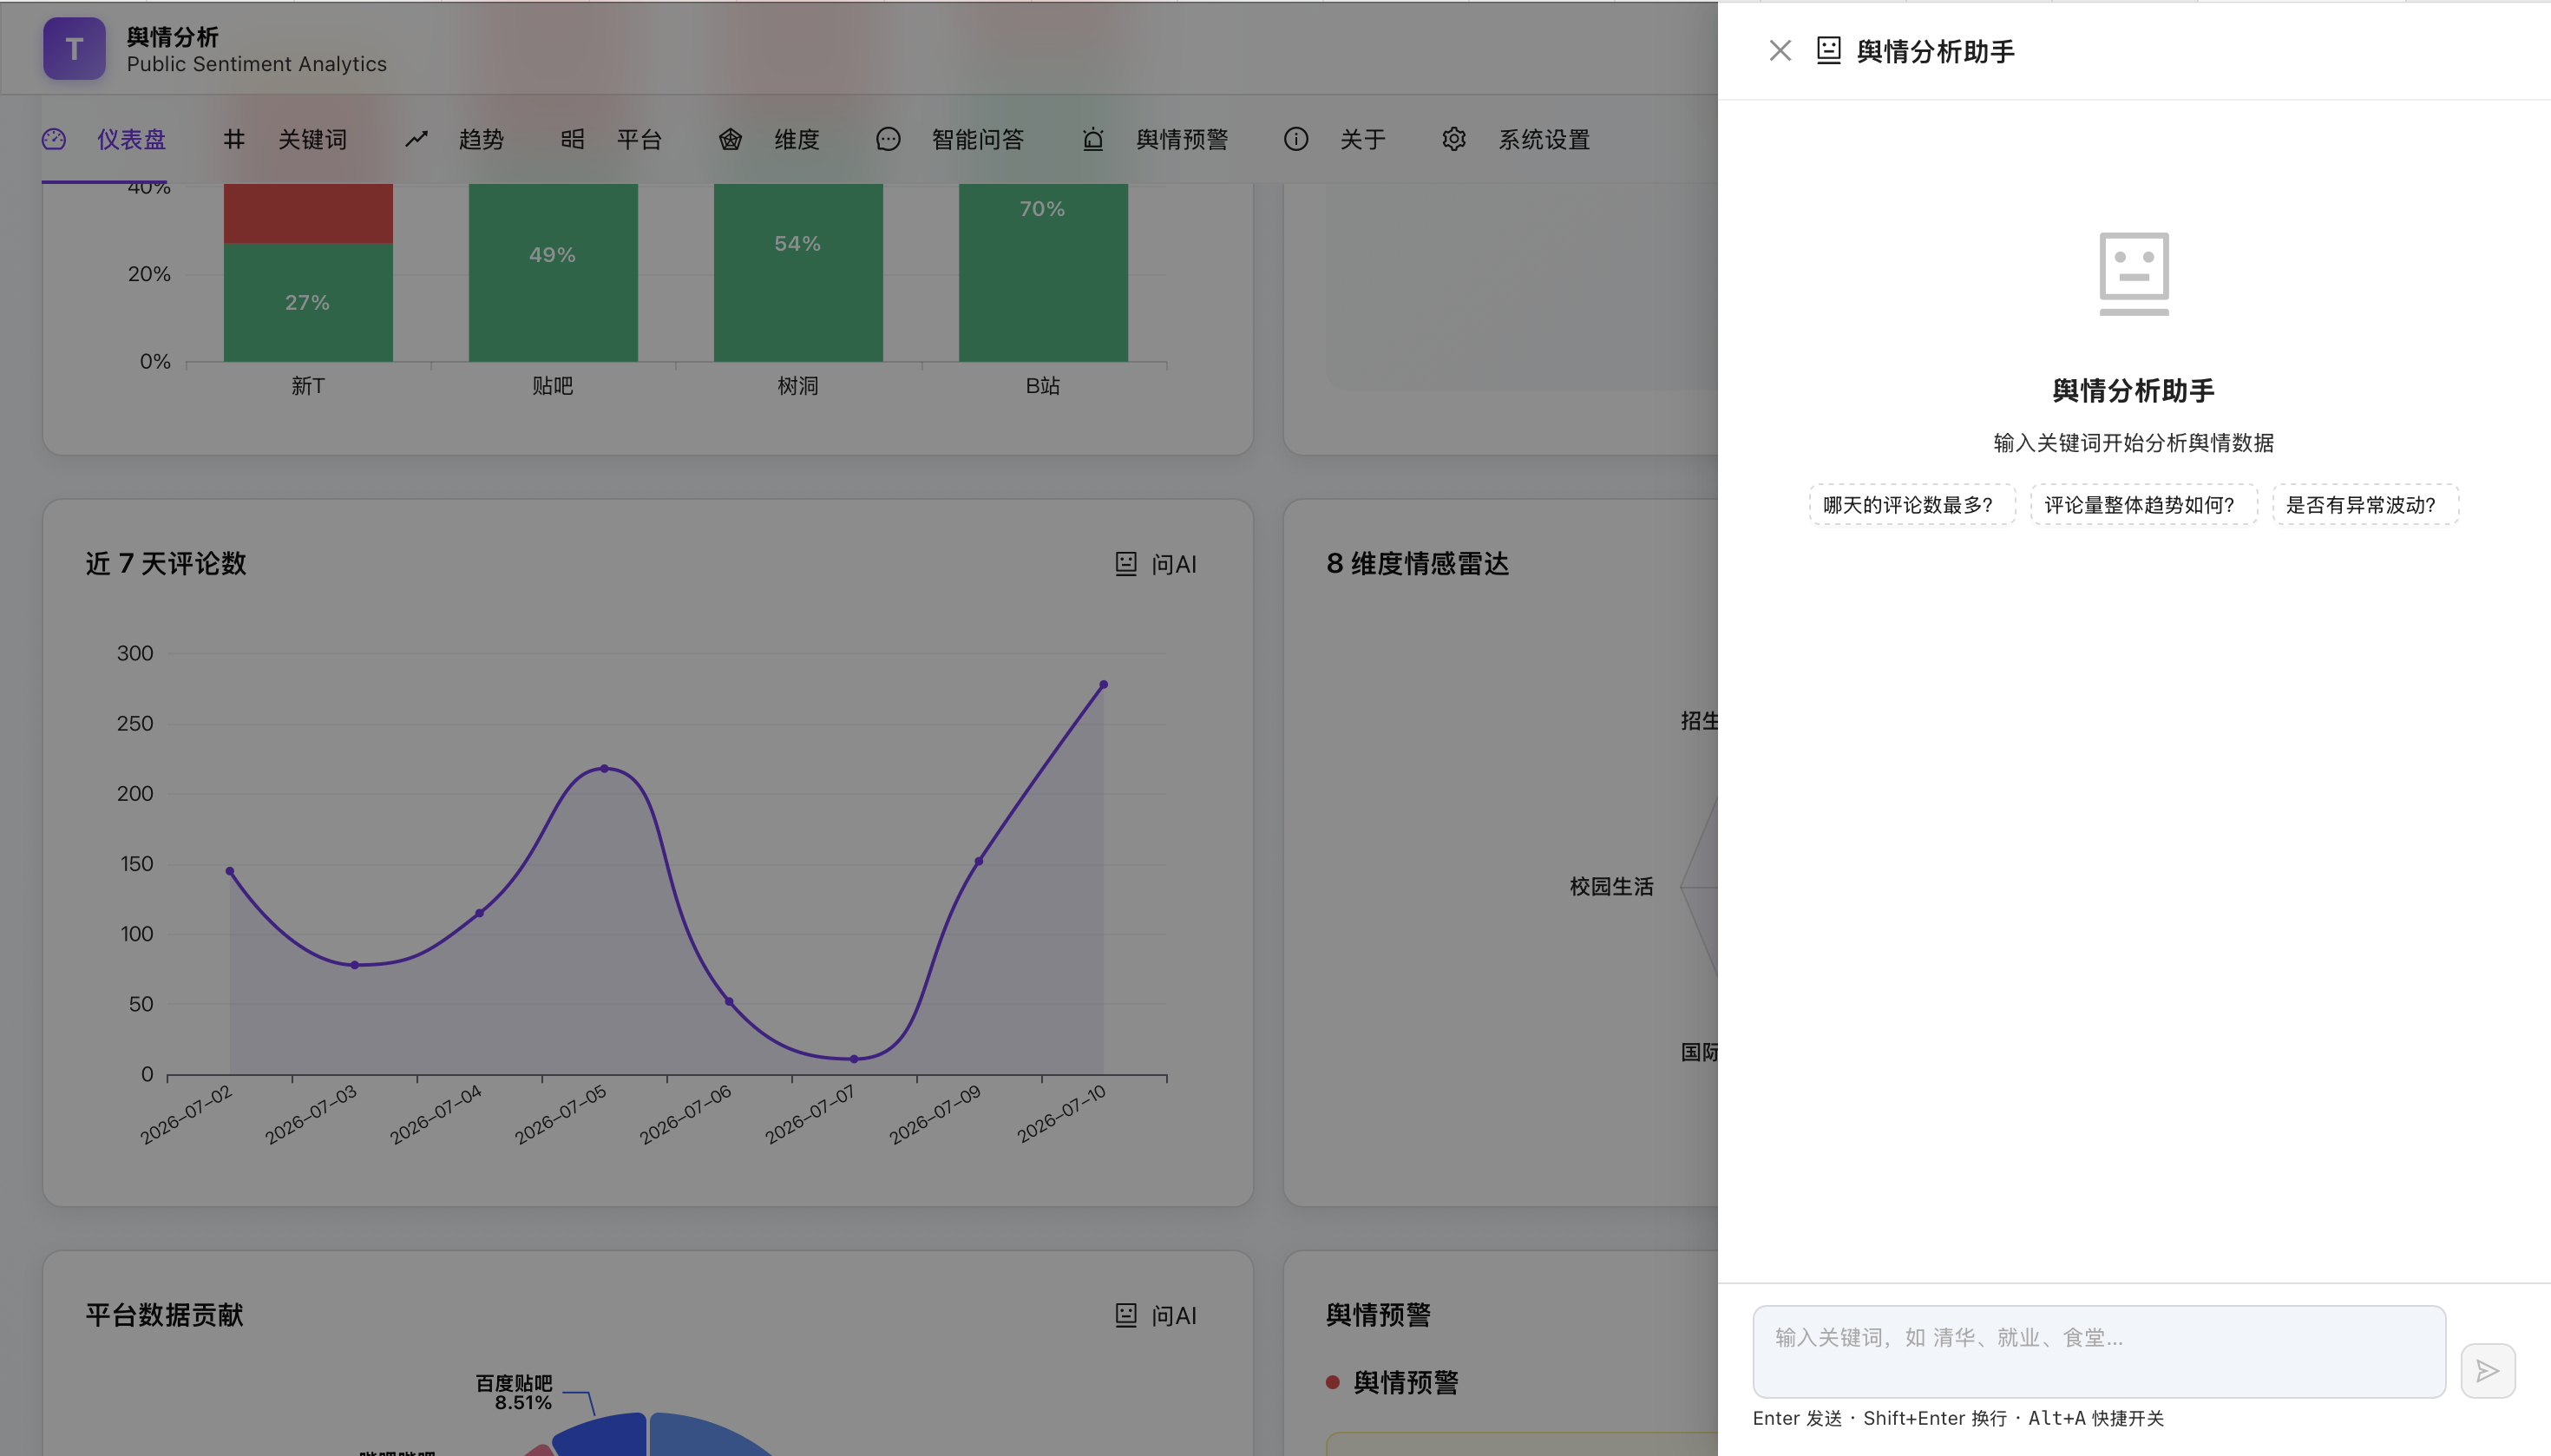
图 8|看板组件内嵌的「问 AI」入口,把当前图表数据作为上下文交给助手
几个我自己比较喜欢的设计:
- AI 分析页为 Agent 的每一次工具调用生成可视化卡片(ToolCallCard),配一个 DeepSeek 风格的思维链折叠面板(ThinkingChain),流式推理时自动展开、完成后自动收起并显示耗时,Agent 的判断依据全程可见
- 舆情预警页的信号与来源双向可追溯,点一下就能看到原始证据
- 看板组件内嵌「问 AI」入口,某一图表的数据可以直接作为上下文开启一段对话
- 系统设置页允许运营人员不改代码就调整调度器参数与预警阈值
开发节奏
| 阶段 | 时间 | 主要进展 |
|---|---|---|
| Week 1 · 探索期 | 6.22 – 6.28 | 定题与分工;各平台试爬;识别出五个后端模块并完成分工;数据库选型与初步建表;情感分析向量雏形成型 |
| Week 2 · 骨架期 | 6.29 – 7.5 | LangChain Agent 工作流从 CLI 跑通;PostgreSQL 上服务器并远程接入;爬虫自动化定时入库;仓库结构重构 |
| Week 3 · 上线期 | 7.6 – 7.12 | Agent 全链路对接检索 / 时序 / 预警模块;前端在服务器上线;长对话上下文;「问 AI」按钮;调度窗口与去重问题收口 |
| Week 4 · 收尾期 | 7.13 – 7.19 | 时区统一、树洞 token、屏蔽词典等细节修复;文档与使用手册;PPT 与演示视频;整体框架图;完成交付 |
团队保持每天一次站会 + 隔天一次线下讨论的节奏,接口对齐放在最高优先级;四周内做过四次比较大的重构:业务流程对齐、数据库字段重设、仓库结构精简、预警与证据模型重构。
我负责的部分
主要承担架构与后端,前后横跨了架构、后端、前端、运维和文档:
- 整体框架与流程设计:定了「浅爬 + 关键词深爬」的两段式采集思路,以及「关键词—得分」向量的最初形态
- 情感分析模块:从零设计入库向量(最初的七个维度:Keyword、情感极性、intensity、frequency、TF-IDF score、source_count、last_seen_time),在几个 BERT 框架里挑精度最高的一个;后来把 pipeline 拆成 sentiment(爬完自动跑)和 association(按需发起)两部分,并统一了各平台数据的接口
- Agent 工作流:基于 LangChain ReAct 与 LangGraph 搭起主流程,写了检索分析、联网搜索等工具;实现长对话上下文,让「追问」能接得上
- 服务器与数据库:在服务器上配环境、部署 PostgreSQL 16 并开放远程接入;建了写入用户和只读用户做权限分离;把 Agent 的数据来源从读 CSV 改成数据库直连
- 爬取自动化:把爬虫改成定时任务并部署到服务器,采集完自动入库;把各平台的爬取时间窗口统一到
config.py,一处改动全局生效 - 前端与收尾:用 vibe coding 的方式做了不少前端功能(「问 AI」按钮、dashboard 分区合并、预警页乱码修复、项目 logo);做了情感分析与 Agent 工作流两部分的 PPT、录了用户端演示视频、整理了整体框架图
踩过的坑
- 版本管理:所有成员都是协作者的时候,需要专人维护仓库。中间经历过一次彻底重构,起因就是无数个文件夹套文件夹和叫不出名字的文件。
- 数据库直连 vs CSV:早期爬虫直连和 CSV 读取混用,字段不一致埋了不少雷。后来统一到服务器上的数据库,字段约束才稳定下来。
- 时区:UTC 与 CST 混用,导致「刚刚聊完的窗口显示成 8 小时前」。统一走北京时间之后才消停。
- 爬虫稳定性:平台一更新就可能失效,校园树洞的 token 还需要定期维护。
- 服务器环境:venv、Docker 镜像源、校园网络,每一样都拦过我们一阵子。
- vibe coding 的边界:用 AI 写代码效率很高,但每次动工前先让 Agent 看一遍现状、写完自己再读一遍,这两步省不得。
写在最后
技术上最大的收获,是理解了 Agent 系统的一种可行形态:把 LLM 当作推理引擎,围绕它搭一圈工具,让 Agent 自己去编排流程。 数据进来了,它自己决定要不要分析、要不要预警、用什么格式输出。而要让这套东西真的可用,靠的还是前面那些不起眼的活儿——清晰的表结构、可靠的数据源、可复核的证据链。
后续可能的改进方向:Agent 工具扩充(报告导出 PDF / Word / Excel、定时自动研判)、多 Agent 协作、爬虫稳健性维护、以及用 Neo4j 做知识图谱支持事件脉络追踪。
