人类投胎模拟器 — 用真实人口数据算一次出生概率
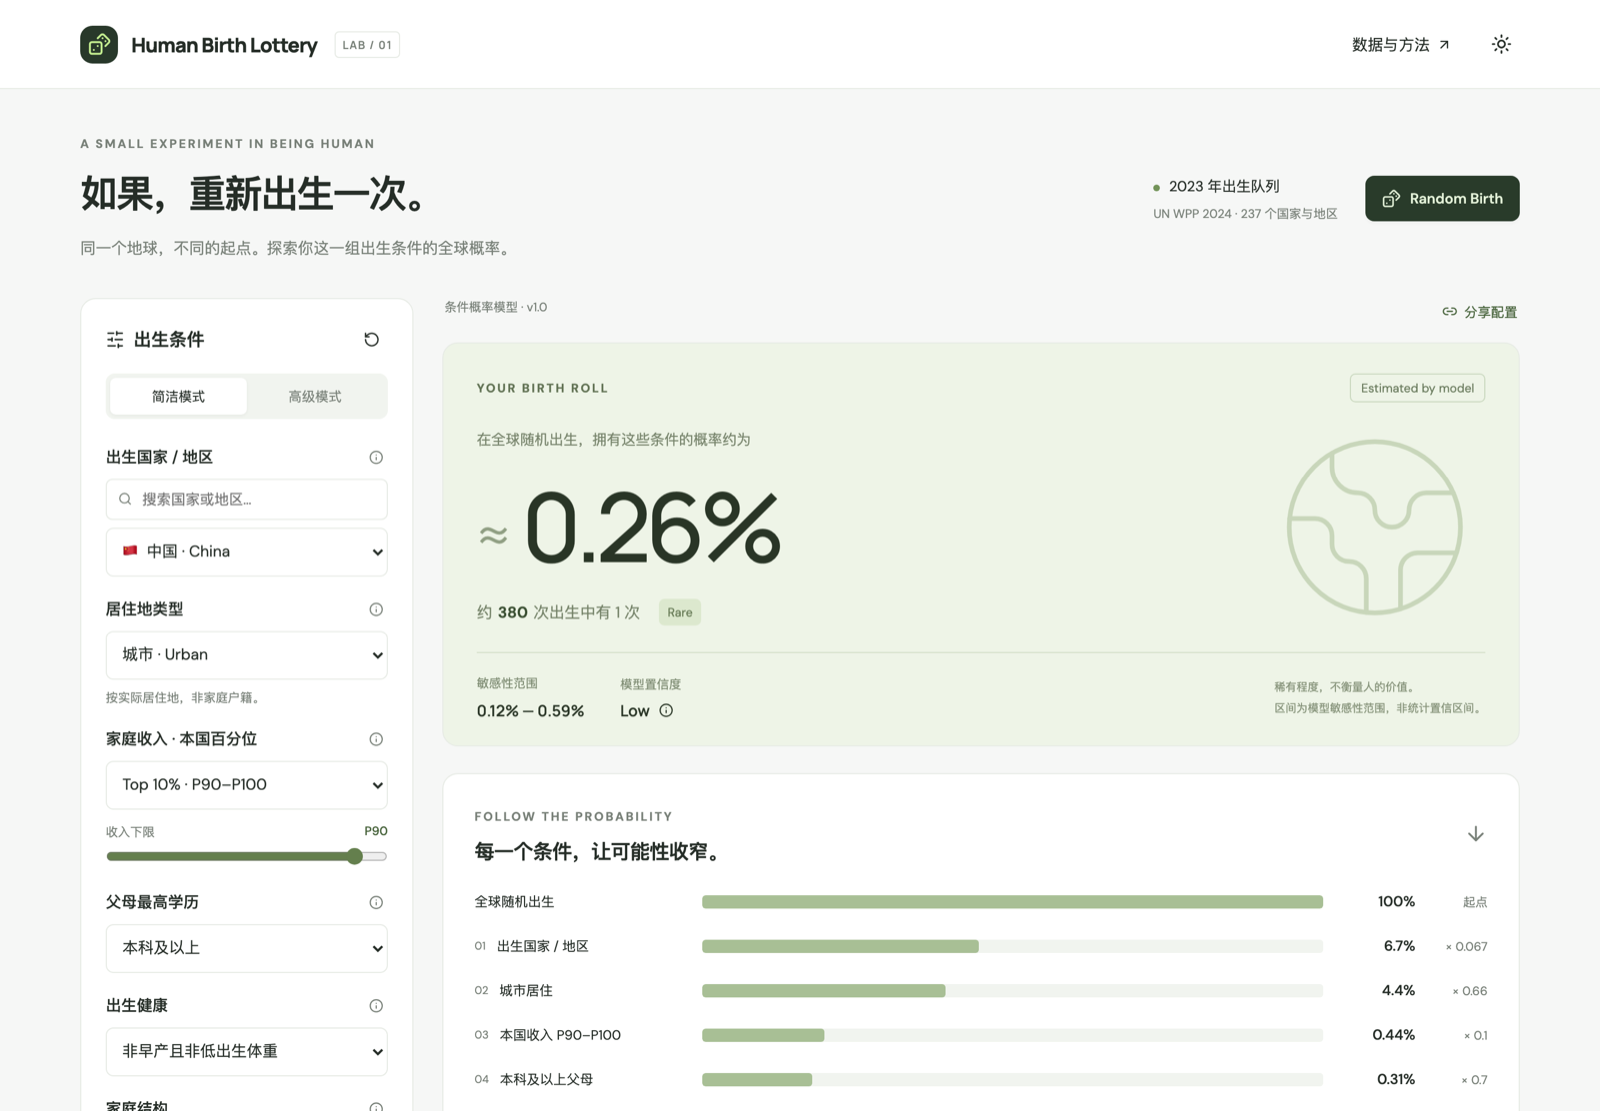
图 1|默认条件(中国 · 城市 · 家庭收入 Top 10% · 父母本科及以上)下的结果
本文介绍一个可交互的出生条件联合概率探索工具(Human Birth Lottery):输入一组出生条件,输出其在全球随机出生中的联合概率,并给出稀有度来源、模型不确定性与物质机会指标。
一、概述
该应用为纯静态 Web 工具,不含后端、数据库与外部 API 依赖,构建产物为静态文件,可直接部署。
输入侧为一组出生条件,输出侧包含四项内容:
- 联合概率与倒数赔率
- 各条件对概率的收窄贡献(概率瀑布)
- 不确定性标注(敏感性范围与置信度分级)
- 物质机会指数及其在全球模型样本中的百分位
二、输入条件与结果呈现
条件面板分为「简洁 / 高级」两档。简洁档包含:
- 出生国家 / 地区:237 个国家与地区,支持搜索,亦可选择「全球随机」或按经济体收入组、地区聚合
- 居住地:城市 / 农村
- 家庭收入:本国百分位,模型内离散为 100 个互斥收入单元
- 父母最高学历:7 档
- 出生健康:三种口径 —— 非早产且非低出生体重 / 上述条件叠加产科医疗与 28 天存活 / 早产或低出生体重
高级档进一步开放家庭结构、教育机会、稳定住房、专业产科医疗、互联网可及、饮用水、卫生设施、电力可及、初中完成(机会代理)、母亲年龄、兄弟姐妹等条件。
以图 1 的默认条件为例,结果为:
≈ 0.26%,约 380 次出生中有 1 次。
同时给出三项限定:稀有度标签 Rare、敏感性范围 0.12% — 0.59%、模型置信度 Low。界面明确标注:该区间为模型敏感性范围,不是统计置信区间;稀有程度仅描述条件分布,不用于评价人的价值。
三、概率模型
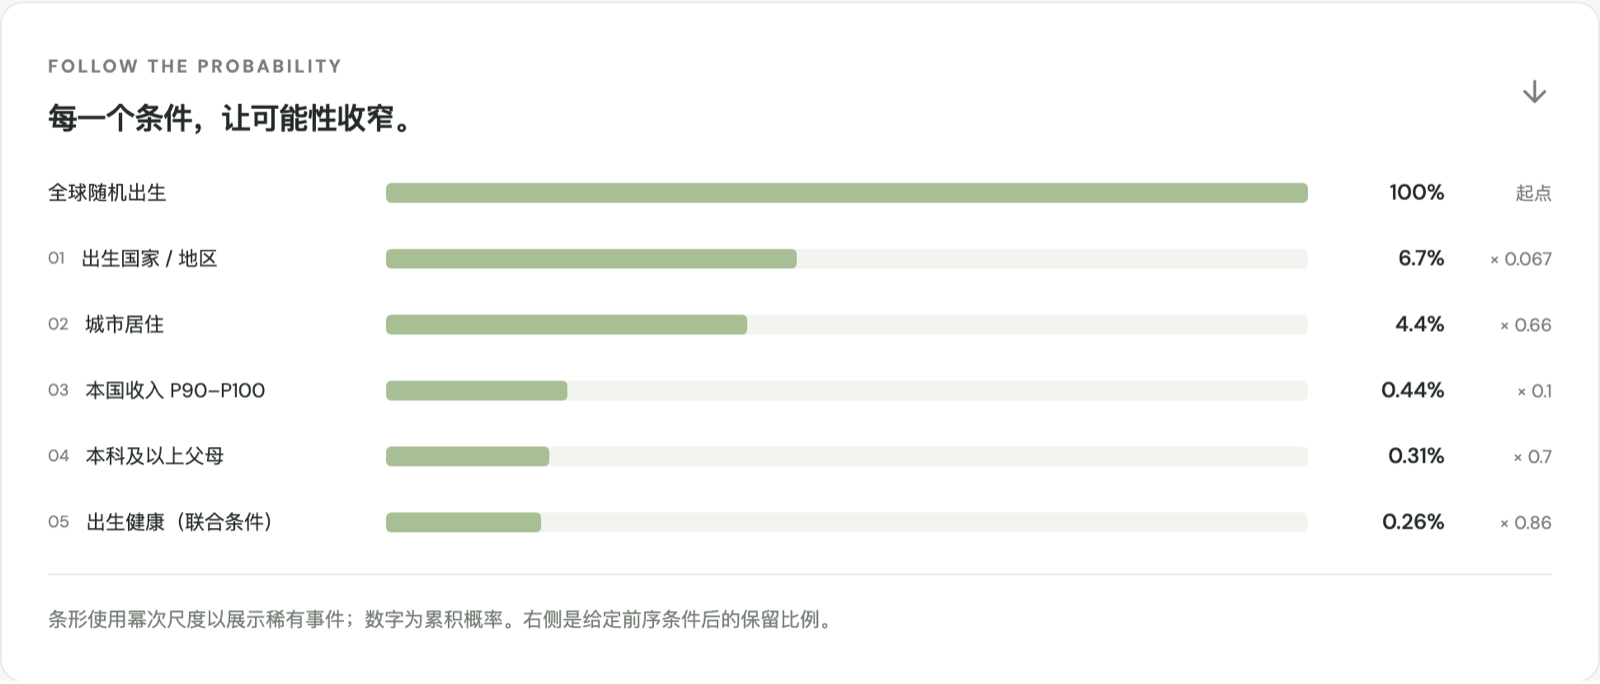
图 2|FOLLOW THE PROBABILITY:逐条件的累积概率与保留比例
同一组默认条件的逐项分解如下:
| 顺序 | 条件 | 累积概率 | 保留比例 |
|---|---|---|---|
| 起点 | 全球随机出生 | 100% | — |
| 01 | 出生国家 / 地区(中国) | 6.7% | ×0.067 |
| 02 | 城市居住 | 4.4% | ×0.66 |
| 03 | 本国收入 P90–P100 | 0.44% | ×0.10 |
| 04 | 本科及以上父母 | 0.31% | ×0.70 |
| 05 | 出生健康(联合条件) | 0.26% | ×0.86 |
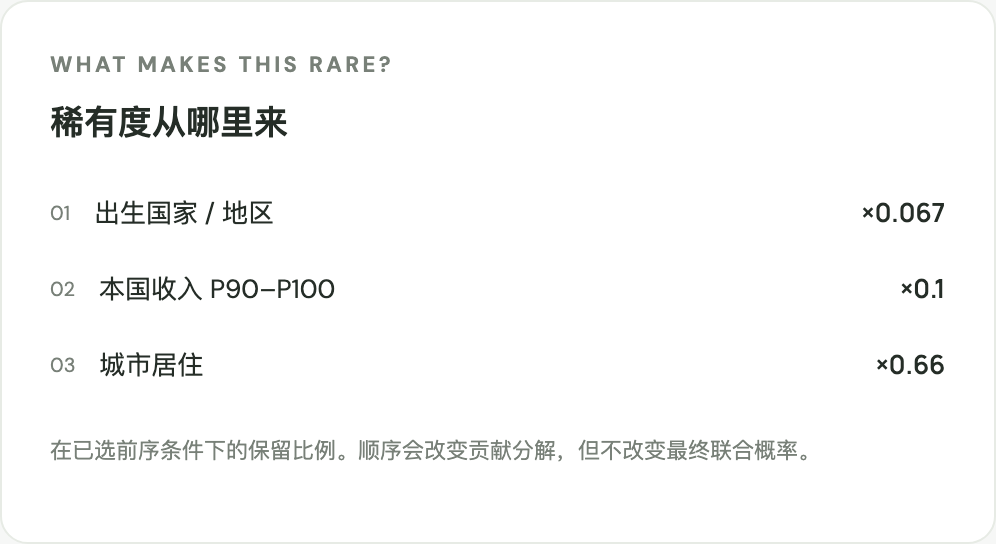
图 3|WHAT MAKES THIS RARE?:按保留比例排序的贡献来源
底层的生成结构如下:
Country ~ 年度出生人数
  └ Residence | Country
     └ Income | Country, Residence
        └ ParentEducation | Country, Residence, Income
           ├ Healthcare | Country, Residence, Income, ParentEducation
           │   └ Preterm → LowWeight → NeonatalSurvival
           ├ EducationOpportunity
           ├ Infrastructure / Completion
└ MaternalAge实现上采用联合枚举,而非对各项比例直接相乘:在固定离散网格上枚举国家 × 城乡 × 100 个互斥收入单元 × 7 档学历 × 2 种医疗状态,未选择的变量做边际化,其余叶节点解析消元。由此保证:
- 收入区间正确嵌套(Top 1% 为 Top 10% 的子集)
- 增加限制条件不会提高概率
- 早产 / 低体重 / 存活三项联合枚举,同一份健康证据不被重复折损
- 互相矛盾的条件直接判定为 0,并给出提示
对外暴露 5 个接口:calculateProbability()、calculateConditionalProbability()(取证据交集)、generateRandomBirth()、simulateBirths(n)(上限 50,000)、compareConfigurations(a, b)(替换参数)。计算引擎运行于 Web Worker,不阻塞主线程。
四、数据来源与覆盖
data/countries.json 为构建期生成的离线快照:
- 出生权重:UN World Population Prospects 2024(经 Our World in Data 传输)。2023 年覆盖 237 个国家与地区共 132,088,956 例活产,WPP 世界总量 132,110,264,覆盖率 99.9839%;未覆盖差额如实标注,不做摊派
- 国别指标 9 项(World Bank / WHO):城市化率、互联网使用人口、基本卫生设施、基本饮用水、电力覆盖、专业人员接生比例、新生儿死亡率、高等教育毛入学率、初中完成率
- 每条指标保存来源 URL、指标代码、年份、数值与类型;缺失值按同地区出生加权均值回退,地区亦缺失时使用全球回退
加权依据采用当年活产人数而非人口比例,可避免出生大国在结果中被系统性低估。
五、不确定性的标注方式
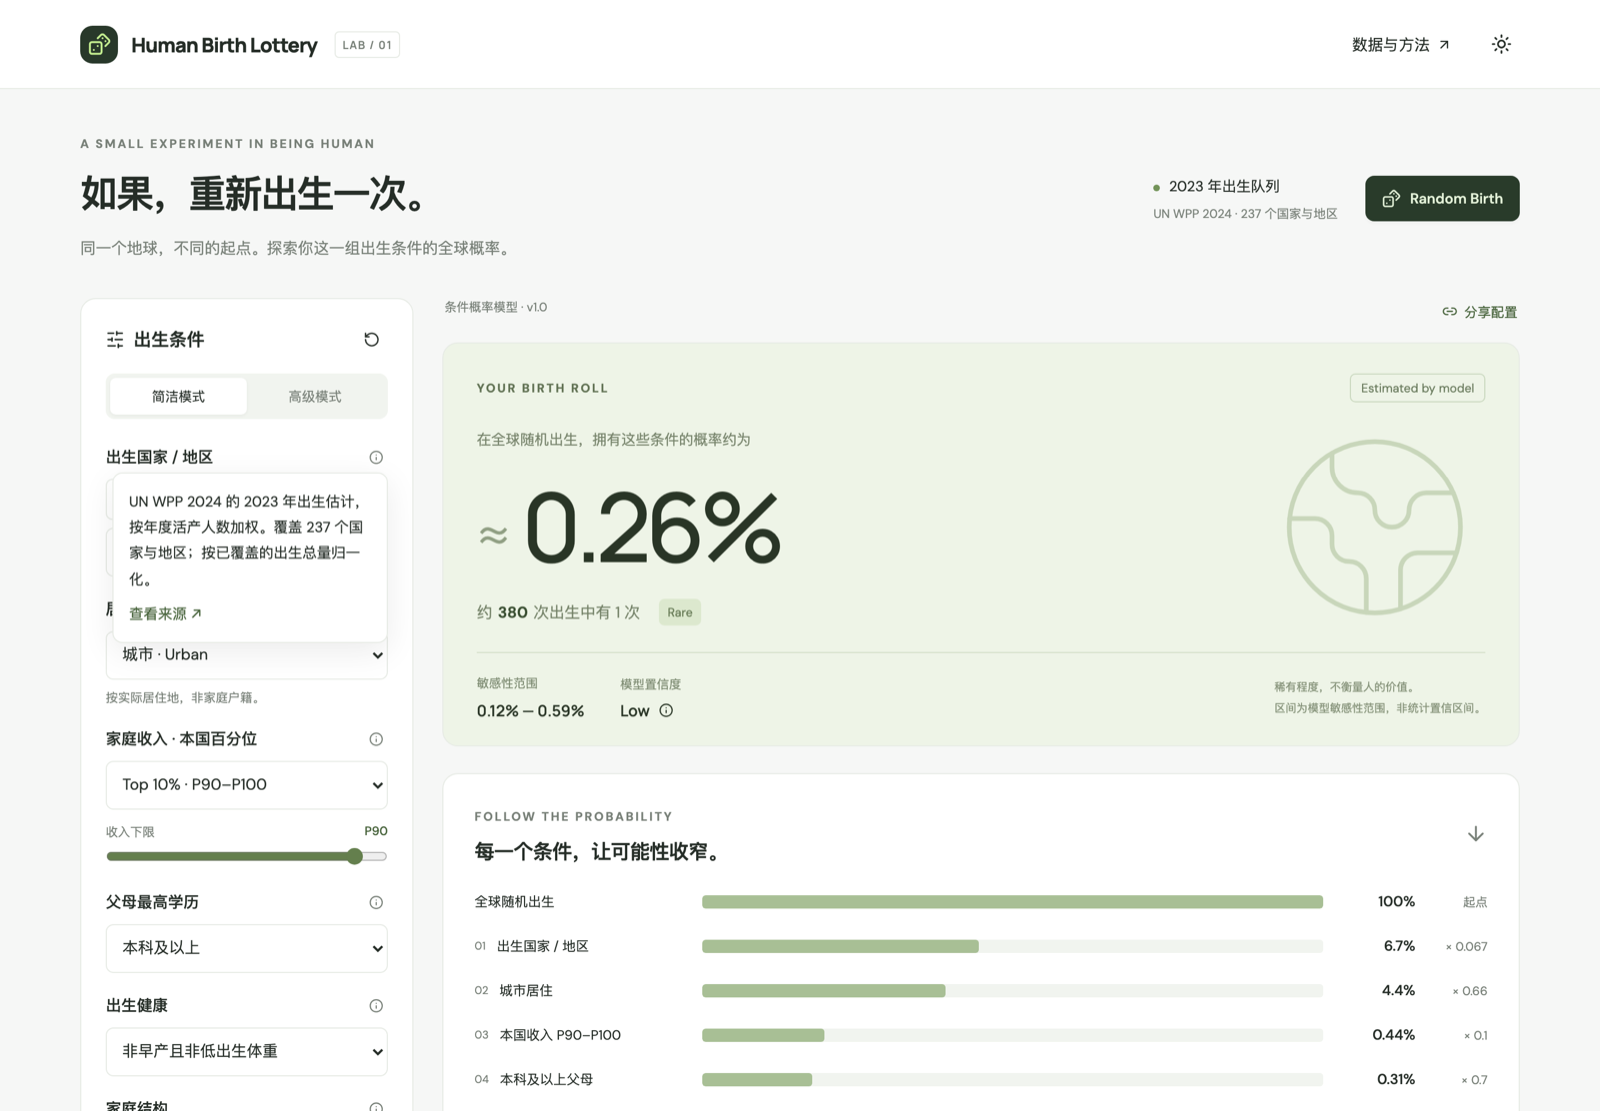
图 4|每个条件均标注其数据性质与适用边界
每一条件的说明条目均写明数据性质与边界,例如:
- 收入:本国百分位的互斥单元,条件于城乡并进行生育率倾斜,不等同于全球收入排名
- 学历:国家高等教育毛入学率仅作为教育背景代理,不表示父母学历比例
- 互联网:个体使用率转换为家庭可及性代理,非家庭接入实测值
- 饮用水:采用 World Bank / WHO–UNICEF JMP 基本饮用水服务指标,与更严格的「安全管理饮用水」指标不等同
- 初中完成率:转换为「未来完成机会」的模型代理,不是高中完成率
- 中国口径:户籍与实际居住地不一致,当前版本未建模户籍,因此未以城市化率替代户籍口径
- 冲突地区暴露:因缺少可靠的次国家冲突与出生交叉数据,该项暂停计算;依据是「国家是否列入脆弱国家名单」与「新生儿是否位于冲突地区」并非同一命题
数据被分为三类标注:national-statistic(实测)、proxy(代理)、model-derived(模型推导),置信度按类别分别计分。默认条件的置信度为 Low,原因是收入与学历均为模型推导结果。
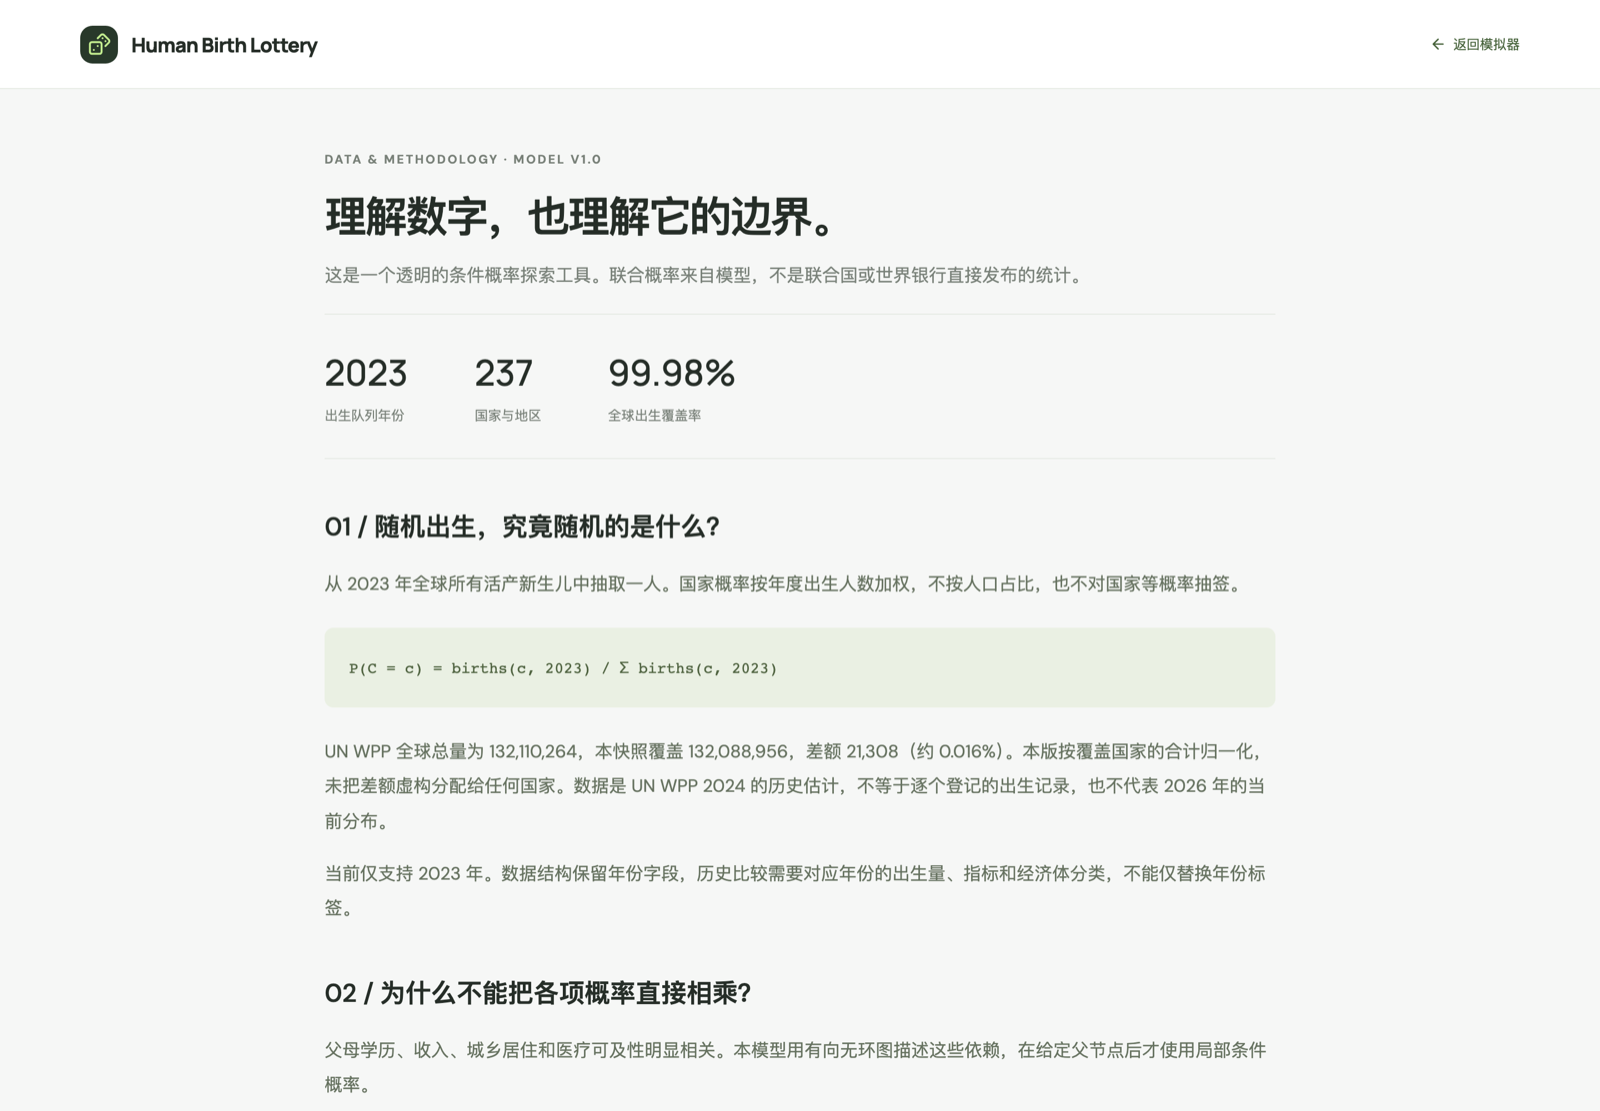
图 5|独立的 DATA & METHODOLOGY 页面
方法页公开了敏感性范围的计算式:
f = min(8, 1.35 + 0.22 × 代理条件数 + 0.25 × 回退指标类数)
显示区间 = [p/f, min(1, p×f)]
并注明该区间不是置信区间,也不表示出生估计没有误差。
六、实验模块
6.1 单次随机出生抽样
按同一条件图采样,生成一张包含国旗、城乡、收入区间、父母年龄、宽带可及与 28 天结局的出生卡。
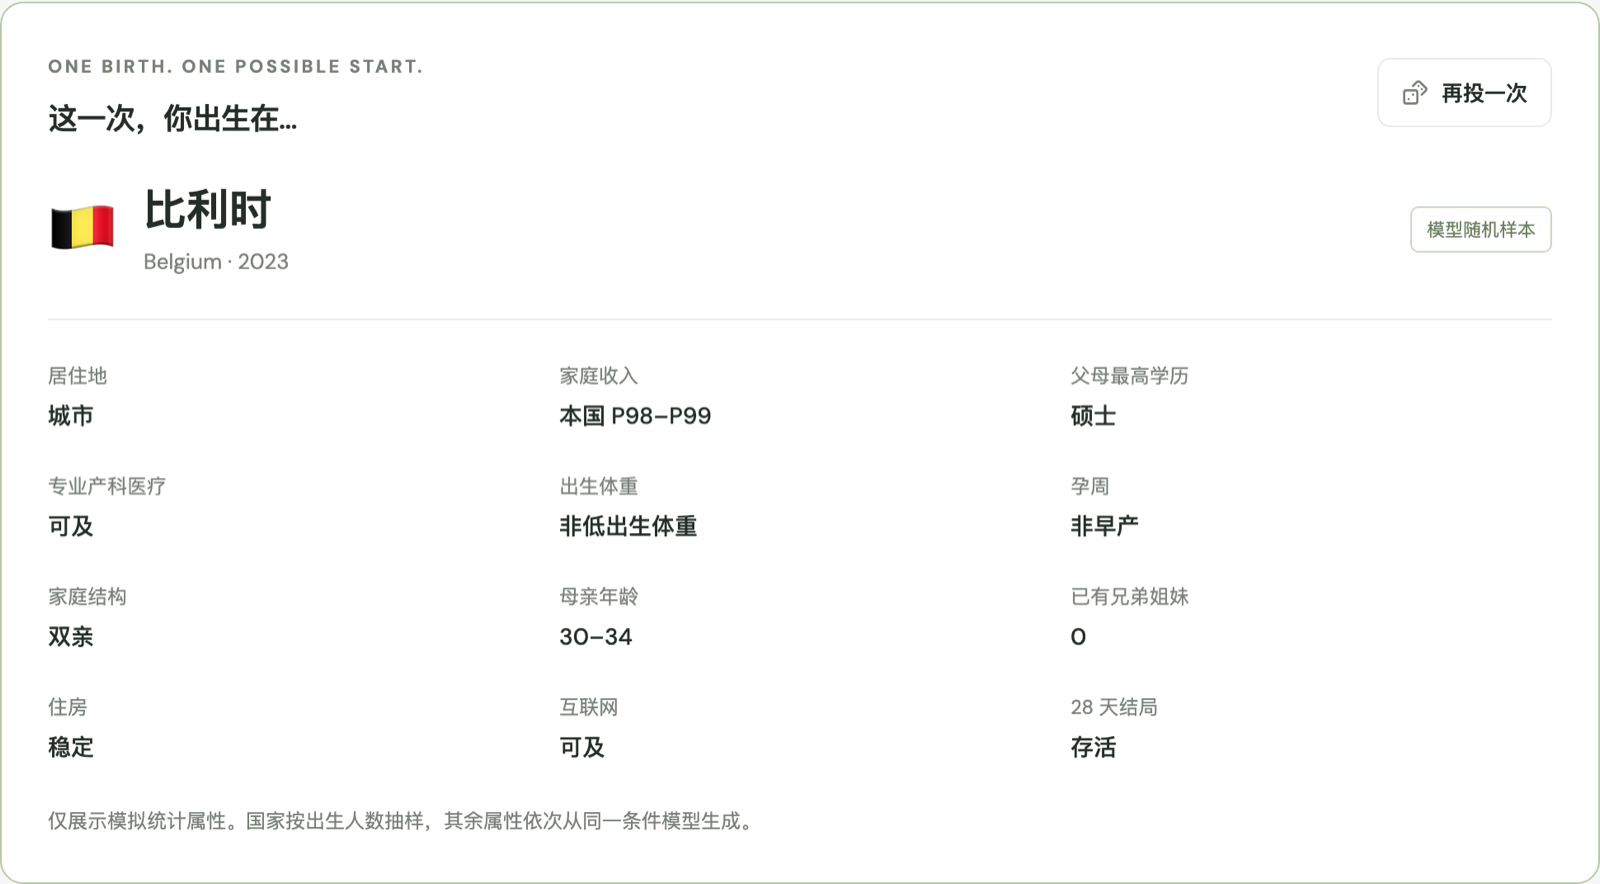
图 6|ONE BIRTH, ONE POSSIBLE START
6.2 单条件对照(What-if)
复制当前配置为 A,仅替换国家 / 城乡 / 收入中的一项作为 B,比较两者概率及比值。以 B 取美国为例,比值约为 0.49×。
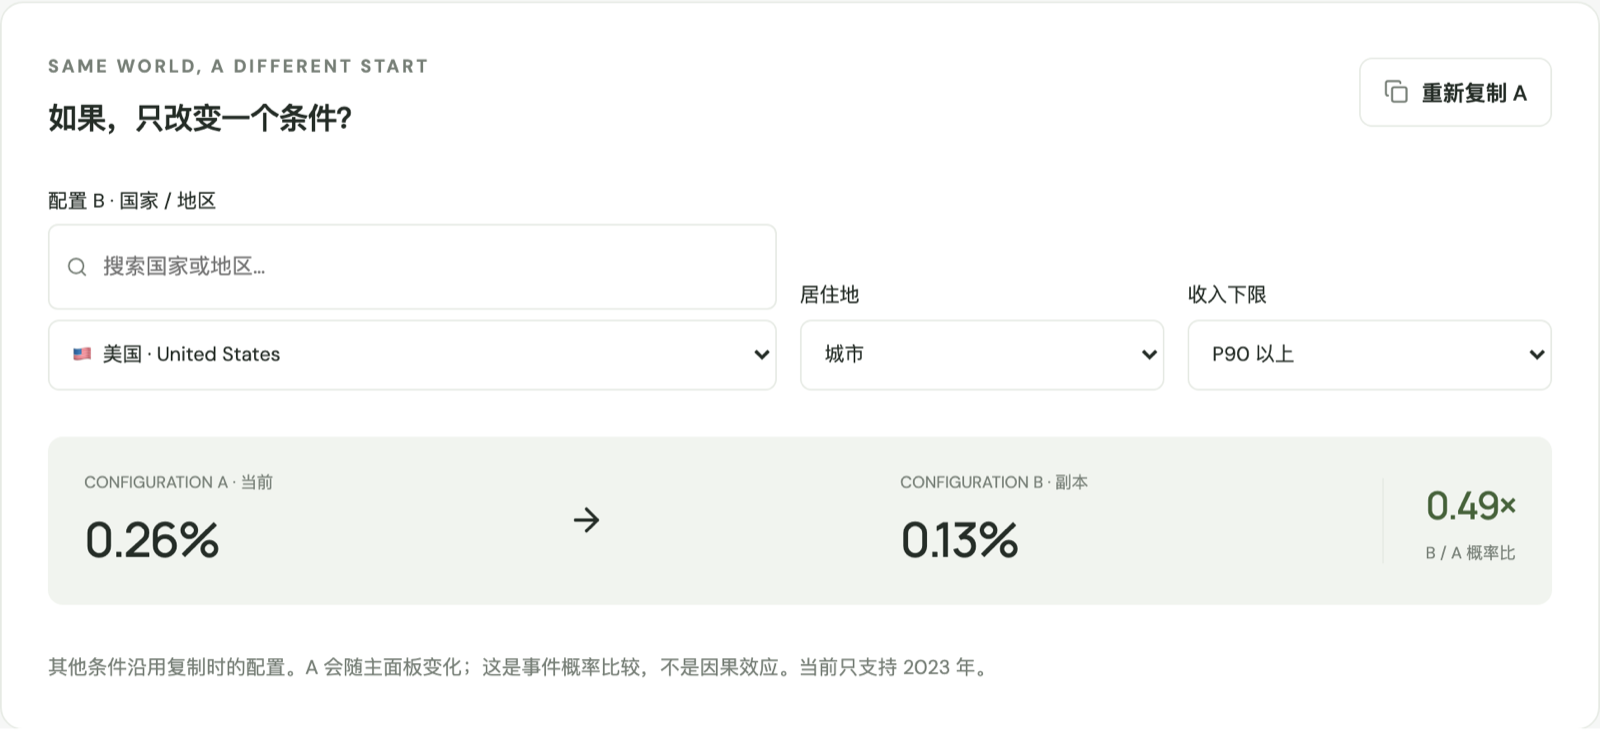
图 7|SAME WORLD, A DIFFERENT START
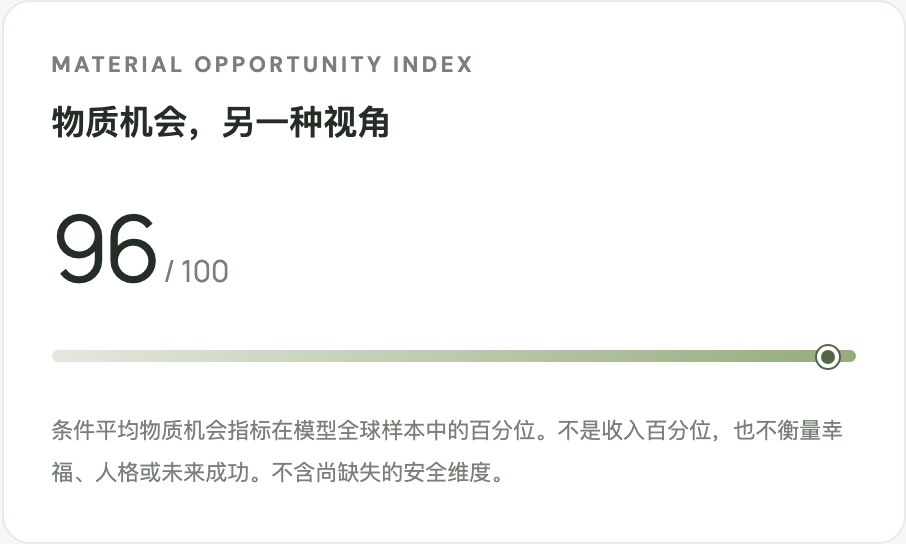
图 8|物质机会指数:由收入 30%、医疗 20%、教育 20%、住房 10%、基础设施 20% 加权构成的模型指标
6.3 蒙特卡洛分布
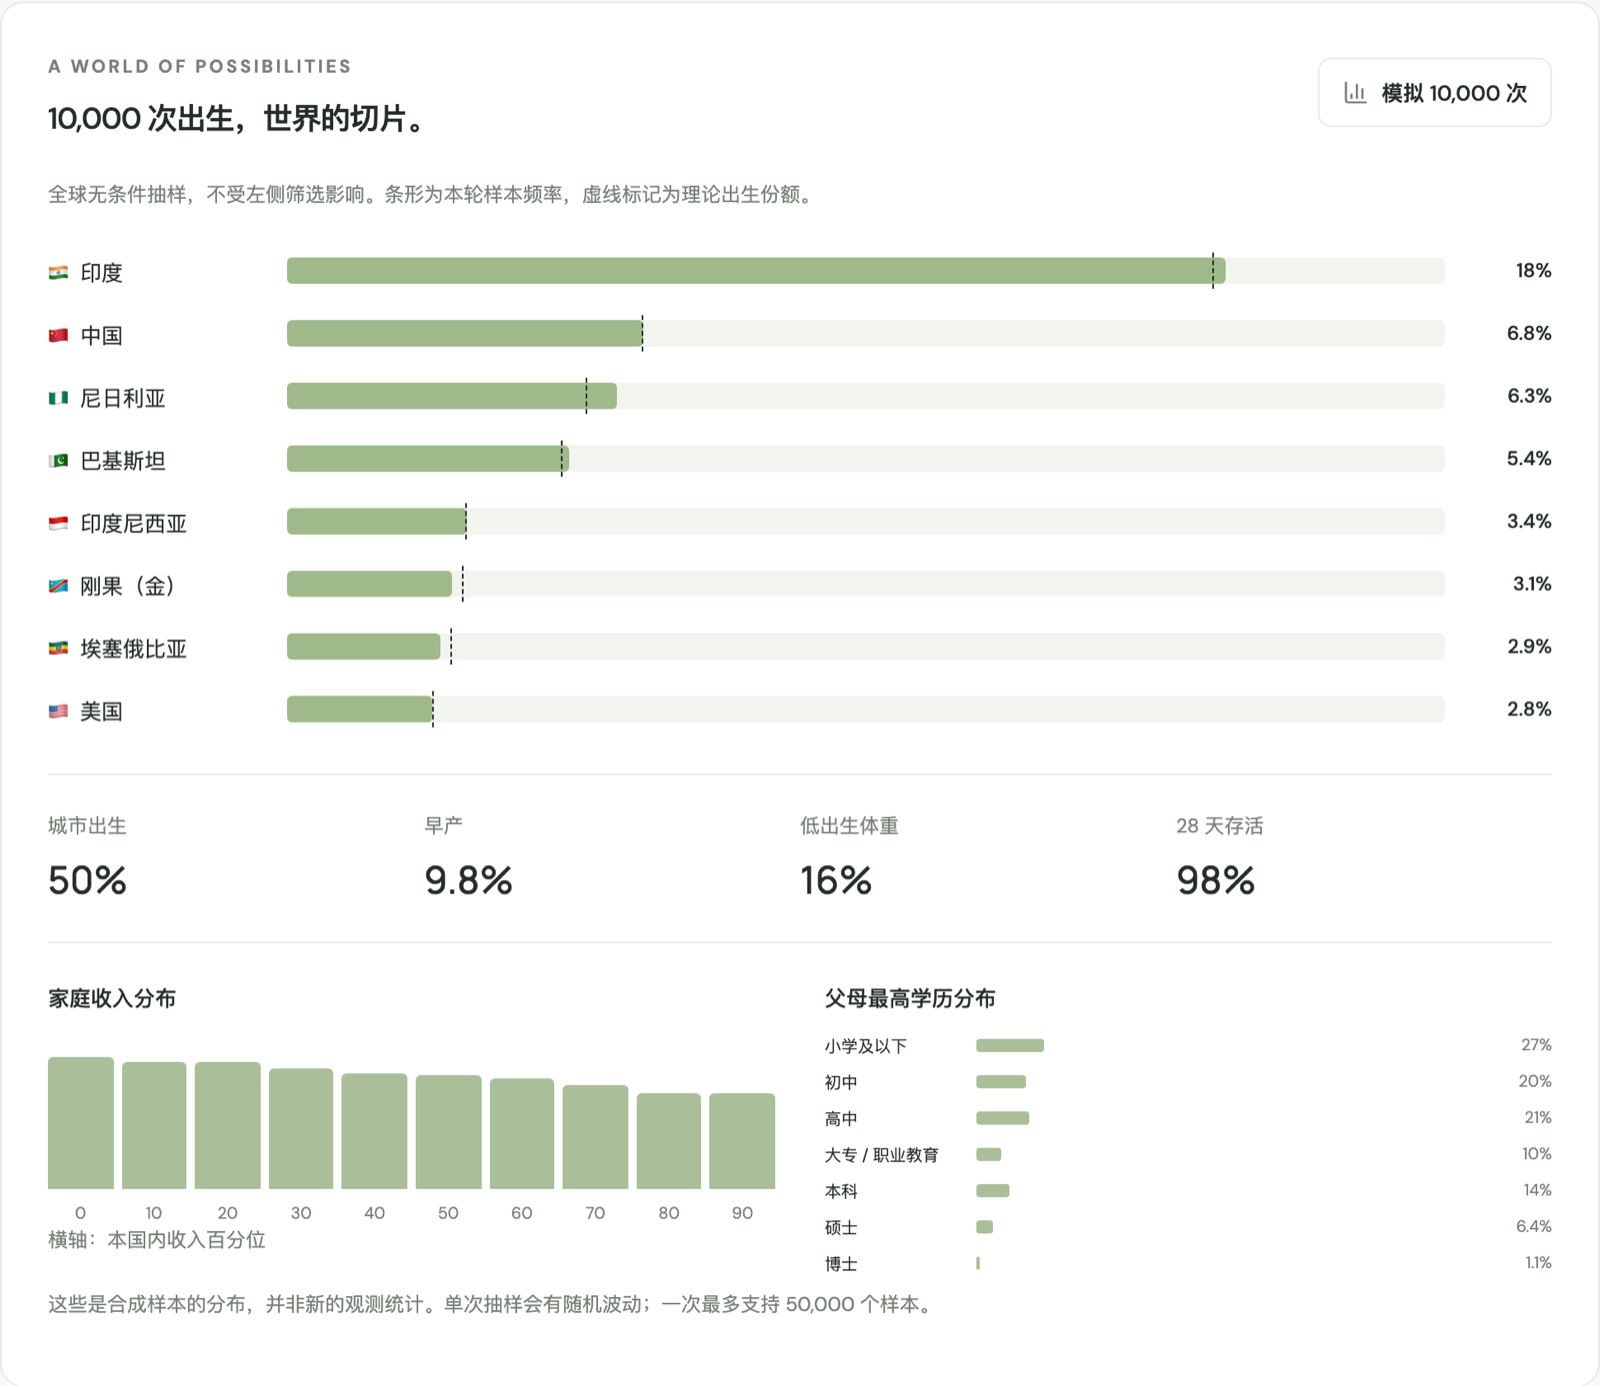
图 9|10,000 次出生抽样:印度 17%、中国 7.1%、尼日利亚 5.5%、巴基斯坦 4.9%……
同一轮抽样同时输出:城市出生 51%、早产 10%、低出生体重 15%、28 天存活 98%;父母最高学历分布中,博士占 1.1%,小学及以下占 27%。柱状为本轮样本频率,虚线为 UN WPP 理论出生份额,两者一致,说明抽样按活产人数加权,而非国家等概率。
6.4 主题与响应式
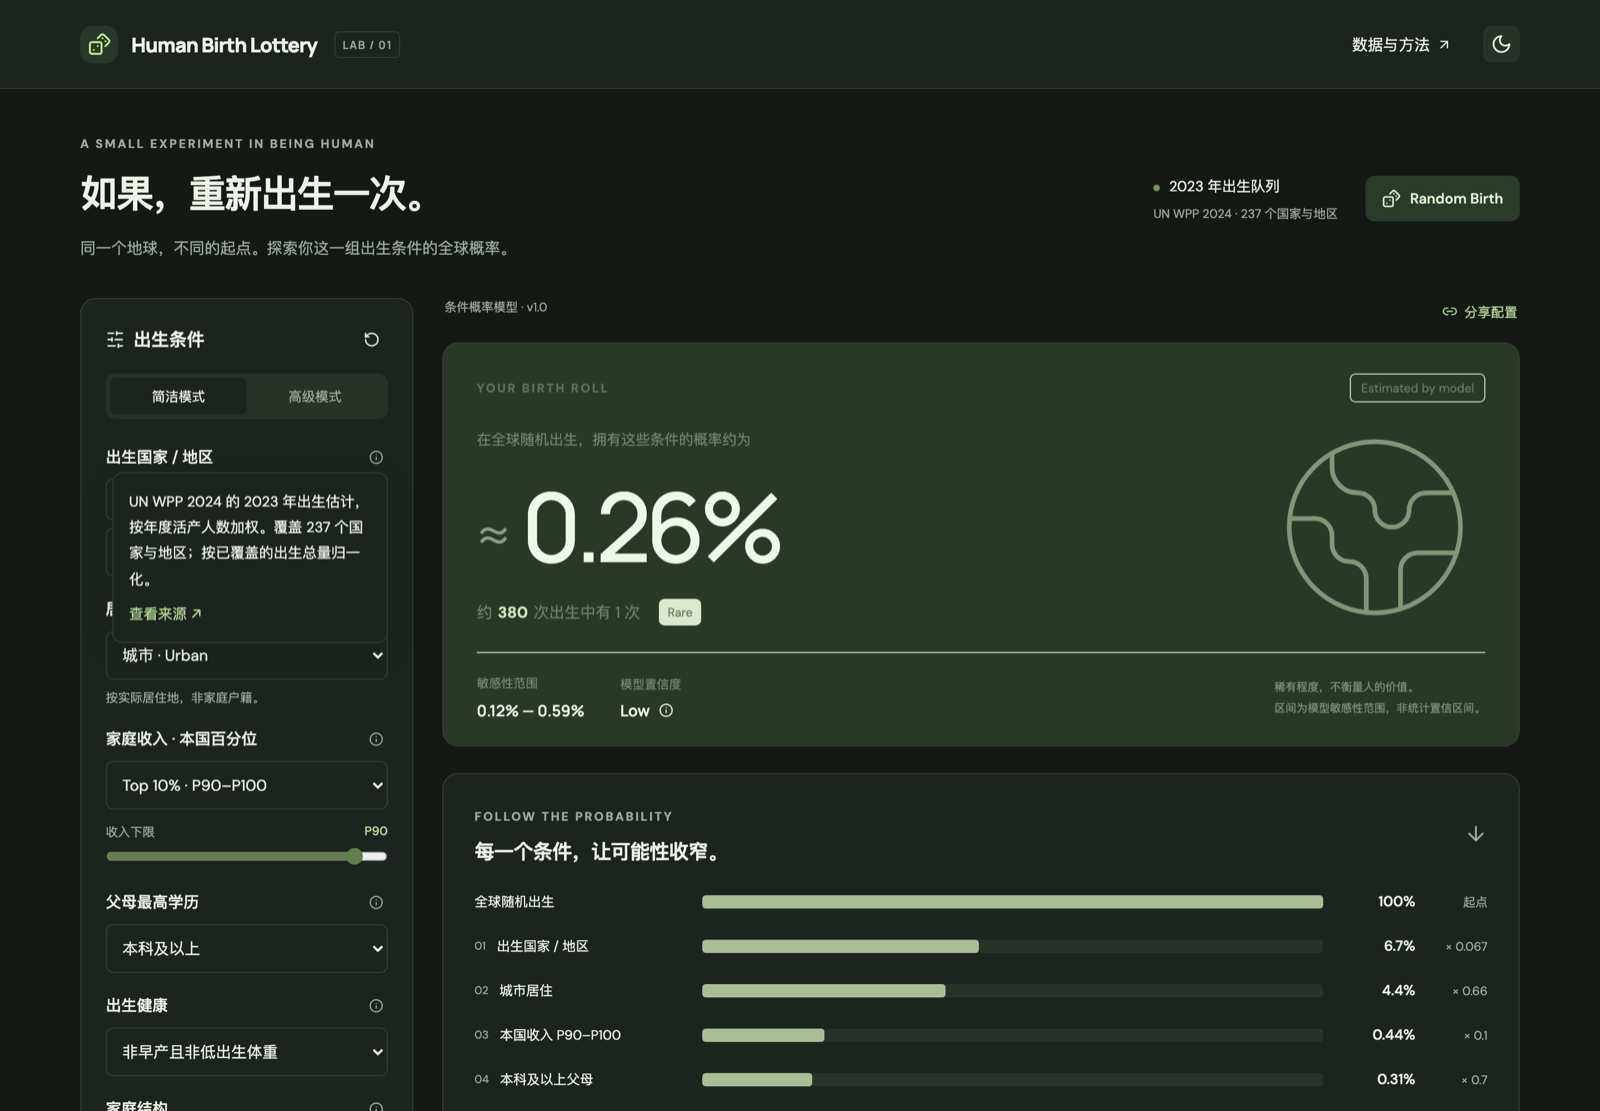
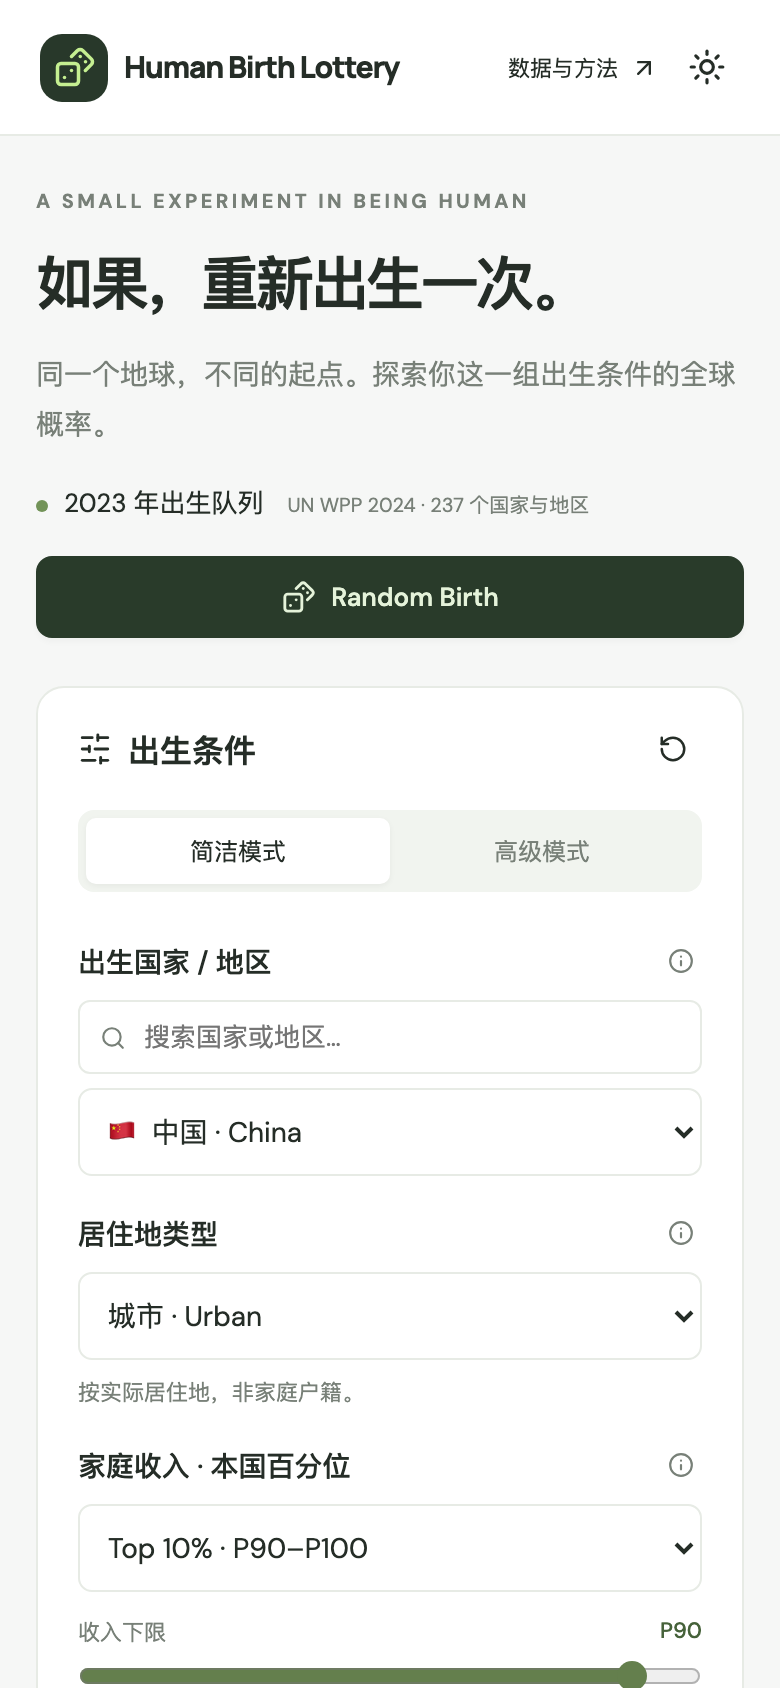
图 10|深色模式与 390px 移动端布局
七、工程实现
| 项 | 情况 |
|---|---|
| 技术栈 | Next.js 16 + React 19 + TypeScript,output: 'export' 静态导出 |
| 代码分工 | probabilityEngine.ts 确定性联合概率model.ts 条件分布与代理回退random.ts 拓扑采样engine.worker.ts 独立线程state.ts URL 校验与序列化 |
| 可分享 | 主配置全部编码入 URL,刷新自动恢复;剪贴板不可用时降级为手动复制 |
| 测试 | 20 项核心模型测试,覆盖归一化、概率范围、嵌套与互斥事件、限制单调性、冗余健康证据、50,000 次国家频率收敛、蒙特卡洛与精确边际一致、URL 回环、缺失数据回退 |
| 浏览器 QA | Playwright 覆盖实时计算、矛盾条件、URL 刷新恢复、随机出生卡、配置对照、10,000 次 Worker 模拟、深色模式、390px 布局与方法页路由 |
| 其他 | ESLint、TypeScript 与生产构建全部通过;npm audit 报告 0 项已知漏洞;WebMCP 渐进增强,支持该 API 的浏览器可通过 generate_random_birth 操作同一张出生卡,不支持时功能不受影响 |
八、已知边界
- 家庭结构、住房、母亲年龄、兄弟姐妹、收入相关系数与父母学历分布均为标注过的探索性先验,不是观测数据;相关系数尚未用 DHS / MICS 微观数据拟合
- 健康模型未额外连入母亲年龄
- 教育机会的三个档位(基础 / 良好 / 丰富)不是 UNESCO 官方分类
- 仅覆盖 2023 单一年份
- 户籍、父亲独立年龄与学历、重大先天异常、疫苗可及性未建模
- PPP 家庭收入与官方不确定性区间未导入
九、后续改进方向
仓库给出的路线是:先以 DHS / MICS 等微观数据估计并校准城乡、收入、父母学历与生育率的联合结构,再导入次国家冲突暴露、PPP 家庭收入与历史年份,随后对参数后验做抽样并进行样本外验证。完成这些步骤后,当前的透明敏感性提示才能升级为有统计支持的不确定性范围。